2x RTX 5060 Ti 対 GB10: 32 GB VRAM が 128 GB 統合メモリに負ける理由
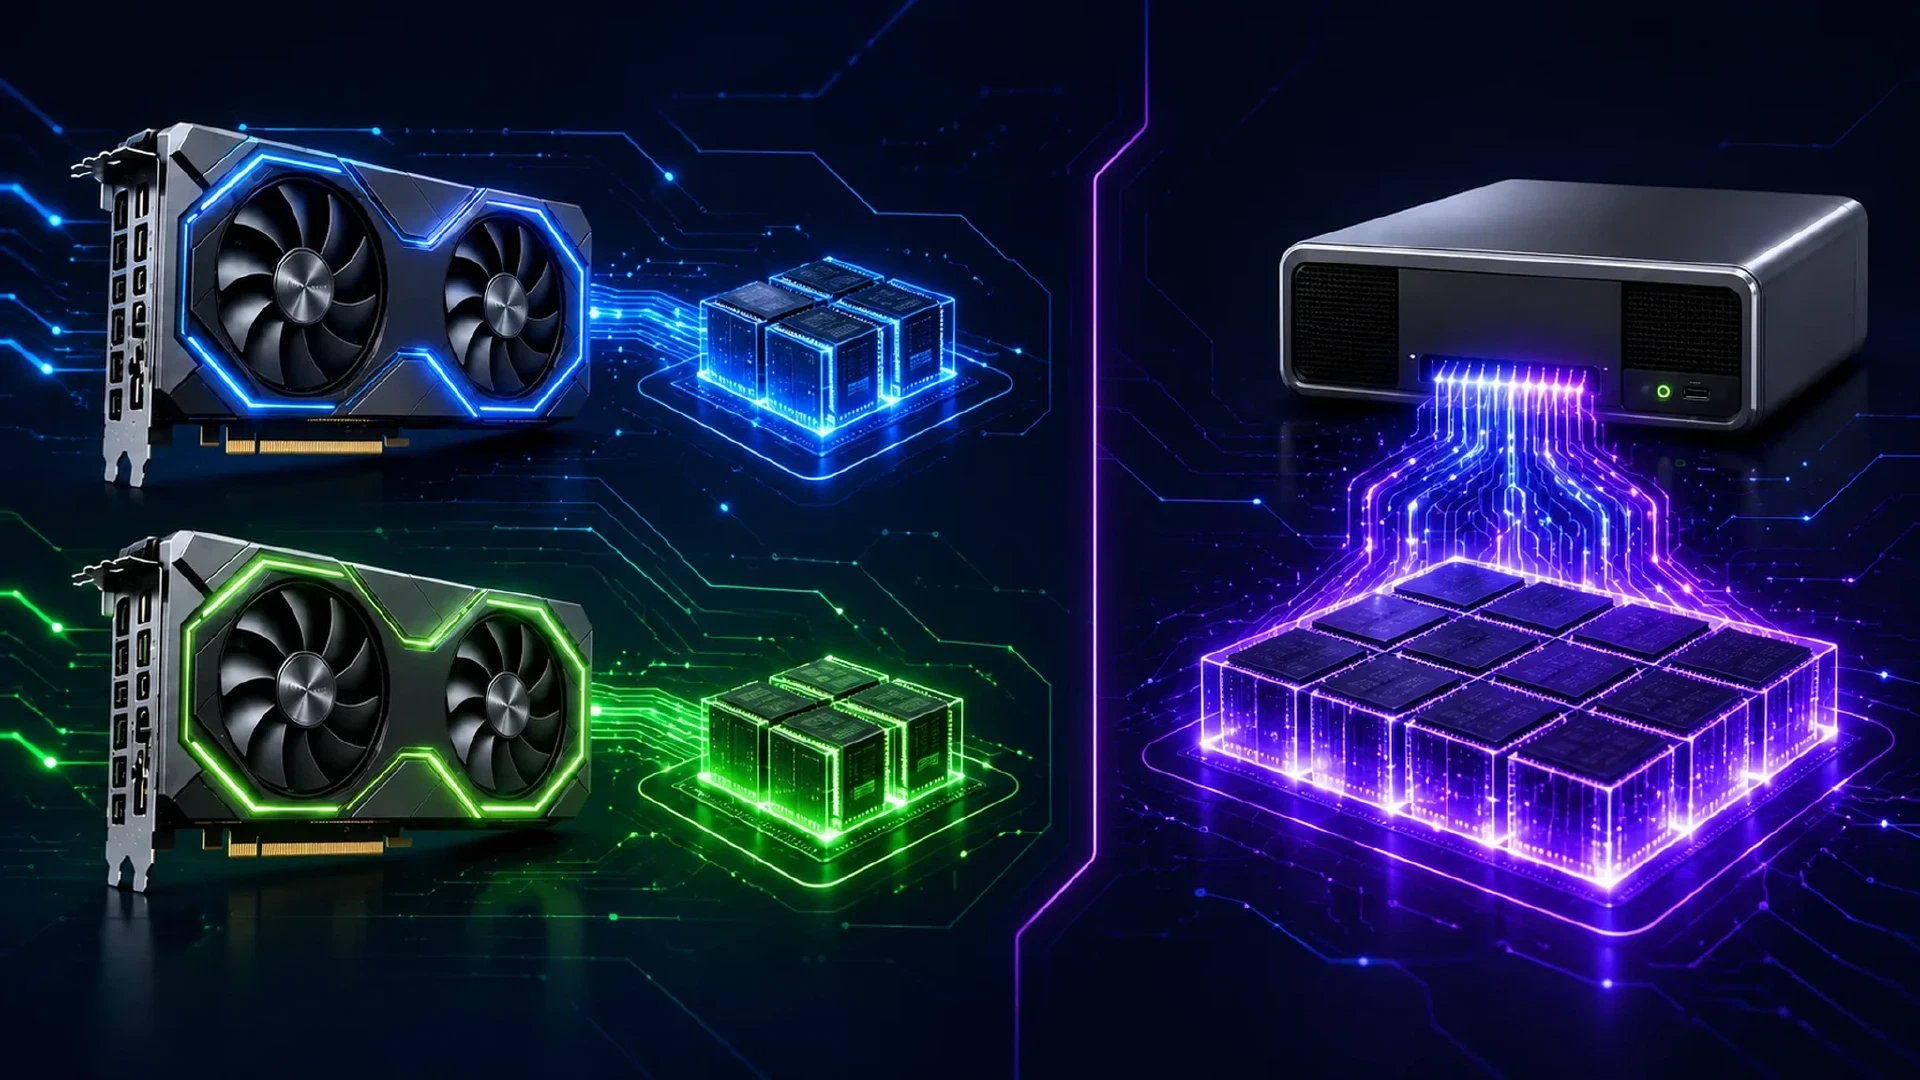
Table of Contents
16 GB の RTX 5060 Ti 2 枚は、パーツ一覧では魅力的に見えます。 合計 32 GB の VRAM と、短いコンテキストでの高いプロンプト処理速度を得られます。27B モデルを長いコンテキストで動かすと、比較結果は変わります。
NVIDIA GB10 システムは 128 GB のコヒーレントな統合メモリを使います。NVIDIA は GB10 プラットフォームについて、128 GB の LPDDR5x 統合メモリと 140 W のチップ TDP を示しています。RTX 5060 Ti はカードごとに 16 GB の GDDR7、128 ビットのメモリインターフェース、180 W の総グラフィックス電力を備えます。 NVIDIA RTX 5060 Ti の仕様 と NVIDIA GB10 の仕様 がハードウェアの違いを示します。
要点は単純です。 16 GB のカード 2 枚は、1 つの高速な 32 GB メモリプールを作りません。ホストシステム経由で接続された、別々の 16 GB プールを作ります。大規模モデルの推論では、カードの枚数より、容量不足とデバイス間のデータ移動が重要です。
メモリの比較
| システム | メモリ | メモリモデル | 公称電力 |
|---|---|---|---|
| 2x RTX 5060 Ti 16 GB | 合計 32 GB | 2 つの独立した GPU メモリプール | GPU 合計 360 W |
| GB10 システム | 128 GB | コヒーレントな統合システムメモリ | GB10 TDP 140 W |
GB10 が勝つ理由は、128 GB の LPDDR5x がハイエンドのディスクリート GPU と同じ帯域幅を持つからではありません。容量と配置が利点です。CPU と GPU は同じアドレス空間を共有します。そのため、モデル、ランタイムバッファ、アクティベーション、コンテキストデータを、2 台の独立した 16 GB デバイスに収める必要がありません。
2 枚構成では、配置の問題が難しくなります。モデルは両方のカードに分散して収まる必要があります。推論ランタイムはカード間でデータを移動します。PCIe トラフィックはレイテンシを増やし、帯域幅を消費します。NVIDIA の仕様によると、RTX 5060 Ti は NVLink にも対応しません。
ベンチマーク結果
以下の結果は、提供された AI ベンチマークレポートから得られたものです。レポートは、5060ti-x2 と呼ぶ名前のないデュアル GPU システムと GB10 システムを比較します。テスト対象は、複数のコンテキストサイズでの Qwen と GPT-OSS です。
モデルは Ollama から直接取得しました。テストでは文字どおりのデフォルトタグ qwen3.8:27b と gpt-oss:latest を使い、カスタム Modelfile や別の量子化は選びませんでした。5060ti-x2 システムは、ベンチマーク時に利用できた最新の NVIDIA Linux ドライバと PCIe Gen4 x16 を使いました。
Qwen のプロンプト処理と生成
| コンテキスト | 5060ti-x2 プロンプト tok/s | 5060ti-x2 生成 tok/s | GB10 プロンプト tok/s | GB10 生成 tok/s |
|---|---|---|---|---|
| 4K | 862.5 | 56.9 | 57.4 | 27.7 |
| 16K | 917.3 | 53.5 | 62.1 | 28.1 |
| 32K | 881.4 | 48.8 | 62.4 | 26.9 |
| 64K | 795.1 | 39.6 | 59.9 | 26.1 |
| 128K | 538.7 | 28.3 | 59.9 | 28.6 |
| 256K | 189.9 | 1.2 | 59.9 | 25.8 |
4K では、2 枚構成の生成速度は GB10 の約 2 倍です。64K では差が約 1.5 倍まで縮みます。128K では、両システムの生成速度はほぼ同じになります。
256K では、2 枚構成の優位性は見えなくなります。5060ti-x2 のリクエストは、実際のプロンプトトークン 171,359 までしか到達しませんでした。生成速度は毎秒 1.2 トークンまで低下しました。GB10 は 256K の完全なテストを毎秒 25.8 トークンで完了しました。
テストした 256K の結果では、GB10 は約 21.5 倍速く生成しました。 さらに重要なのは、GB10 が要求されたコンテキストを完了したことです。2 枚構成は同じワークロードを完了していません。
合計 VRAM が誤解を招く理由
1. モデルから 32 GB の 1 枚のカードは見えない
2 枚の GPU は、メモリを 1 つのローカルアドレス空間に統合しません。モデル並列ランタイムは、レイヤーやテンソルをデバイス間に分割します。各デバイスには、割り当てられた重み、テンポラリバッファ、コンテキスト状態の一部を置く空間が必要です。
したがって、使用可能な容量は単純な合計より小さくなります。正確なオーバーヘッドは、モデル形式、量子化、推論バックエンド、テンソル分割、コンテキスト長に依存します。
2. 生成中にコンテキストメモリは増える
モデルの重みはメモリ予算の一部にすぎません。キー・バリューキャッシュ、つまり KV キャッシュは、過去のトークンのアテンションデータを保存します。長いコンテキストには、より多くのキャッシュメモリが必要です。4K のテストは 128K や 256K の展開を予測しません。
提供された結果は、この境界を明確に示します。2 枚構成はプロンプト処理では大きく先行しますが、コンテキストが長くなると生成性能を失います。GB10 は 4K から 256K まで、毎秒約 26 から 29 生成トークンを維持します。
3. PCIe 転送にはコストがある
ランタイムが GPU 間でアクティベーションやテンソルを移動すると、転送はホストインターコネクトを通ります。各ステップに同期点とレイテンシが追加されます。ワークロードがデバイス境界を何度も越えるほど、ペナルティは大きくなります。
これはデュアル GPU システムが役に立たないという意味ではありません。メモリ配置は性能結果の一部です。4K のプロンプト処理だけを報告するベンチマークでは、このコストを見落とします。
4. 電力効率はシステム全体の利点
この比較では、GB10 は少ない電力で、テストした長いコンテキストのワークロードに多いメモリ容量を提供します。RTX 5060 Ti 2 枚は、システムの他の部分を含める前に GPU 合計 360 W です。NVIDIA は GB10 の TDP を 140 W としています。
GB10 は短いコンテキストでの最高速度と引き換えに、容量、完了性、低い GPU 電力を得ます。 長いコンテキストの Qwen 推論では、これらの違いが重要です。
5060ti-x2 システムは大幅に安い
性能比較をしても価格差は消えません。16 GB の RTX 5060 Ti 2 枚を搭載した完全なワークステーションは、2026 年 10 月 10 日に $3,479 で掲載されていました。構成には Intel Ultra 7 265K、Z890 マザーボード、32 GB DDR5、1 TB ストレージ、1,000 W 電源、2 枚の GPU が含まれます。 完全なデュアル GPU ワークステーションの掲載を見る 。
NVIDIA の米国マーケットプレイスでは、128 GB の DGX Spark が $6,950 です。掲載内容には 128 GB のコヒーレントな統合メモリと 4 TB の NVMe ストレージが含まれますが、在庫切れと表示されています。 NVIDIA の現在の DGX Spark 掲載を確認する 。
AMD Ryzen AI Halo Developer Platform も比較対象になります。この Strix Halo システムは Micro Center で $3,999.99 と表示され、128 GB の LPDDR5x 統合メモリと 2 TB のストレージを備えます。Strix Halo は実用上、GB10 システムと同じローカル AI の分類に入ることが多いものの、独立テストではスループットとソフトウェア成熟度で GB10 が先行することが多いです。 Micro Center の現在の Linux 掲載を確認する 、 Strix Halo と GB10 のレビューを読む 。
| 完成システム | 2026 年 10 月 10 日の掲載価格 | 価格差 |
|---|---|---|
| 5060ti-x2 ワークステーション | $3,479 | 基準 |
| AMD Ryzen AI Halo、Strix Halo | $3,999.99 | $520.99 高い |
| 128 GB GB10 DGX Spark | $6,950 | $3,471 高い |
GB10 は、より大きな統合メモリプール、低い電力使用量、長いコンテキストに適したアーキテクチャを提供します。AMD システムは約 $4,000 で同じ 128 GB クラスのメモリを提供します。5060ti-x2 ワークステーションは、税金と送料を除くと、掲載された GB10 価格の約 50% です。統合メモリは必要だが NVIDIA のソフトウェアスタックは必要ない購入者には、Strix Halo が低価格の選択肢になります。
これらは異なるベンダーの掲載価格であり、管理された小売価格の比較ではありません。比較では、5060ti-x2 システムのシステムメモリとストレージも少なくなっています。それでも価格差は重要です。どちらも GPU 単体ではなく、使用可能な完成コンピュータを示しているからです。現在の RTX 5060 Ti 16 GB カードは 1 枚 $789 から $830 付近で、発売 MSRP の $429 を大きく上回ります。そのため、現在の GPU 価格上昇中でも 2 枚構成の価格優位は残ります。 現在の RTX 5060 Ti 価格を確認する 。
GPT-OSS の結果は別に扱う
同じレポートでは、4K から 256K まで GPT-OSS の 5060ti-x2 生成結果が良好です。GB10 は 4K から 128K のテストを完了しますが、256K の GPT-OSS テストは未対応と記録されています。
GPT-OSS の表を使って、普遍的な勝者を主張しないでください。256K で同じ範囲をテストしていません。Qwen の結果は、両システムが 256K の結果を報告しているため、長いコンテキストを比較するうえで明確です。ただし 5060ti-x2 の実行は実際のプロンプトトークン 171,359 までしか到達していません。
Qwen 3 27B の構成にとっての意味
16 GB のカード 2 枚の構成なら、短いコンテキストで量子化した 27B モデルを動かせる可能性があります。ベンチマークはこの用途を否定していません。データが否定するのは、合計 32 GB の VRAM が 128 GB の統合メモリシステムと同じ実用的な余裕を提供するという主張です。
モデルがカードに収まることが証明するのは、重みの容量だけです。 実際のメモリ要件は、モデルの重み、アクティブなコンテキスト、KV キャッシュ、ランタイムバッファ、OS の余裕の合計です。コンテキストはモデルと同時に収まる必要があります。ロードできても会話を処理する余地がないモデルは、長いコンテキスト向けの実用的な構成ではありません。
これは、重み、コンテキスト、ランタイム割り当てを 1 つの予算として扱う 深刻なローカル LLM 作業に 16 GB VRAM は十分か のサイズ指針と一致します。2 枚構成については Qwen 27B 用 32 GB VRAM ガイド も同じ結論です。合計容量は使用可能な余裕と同じではありません。
Qwen 3 27B 用のハードウェアを購入する前に、次の 4 点を確認してください。
- 要求した量子化はランタイムバッファと一緒に収まるか。 モデルの重みだけでは必要メモリは決まりません。
- 強い KV キャッシュ圧力なしでコンテキストは収まるか。 長いプロンプトは結果を変えます。
- ランタイムは高速なデバイス分割を使うか。 PCIe 転送とテンソル配置は生成する各トークンに影響します。
- システムは目標コンテキストを完了するか。 速い 4K の結果は、失敗した 256K ワークロードを補いません。
提供されたテストは、2 枚構成について最後の質問に答えています。実行は 256K の Qwen リクエストで 171,359 トークンに達し、毎秒 1.2 トークンで生成しました。GB10 は 256K を毎秒 25.8 トークンで完了しました。
この長いコンテキストのワークロードでは、代替構成が PCIe でモデルのワーキングセットを分散する場合、統合メモリの方が適したアーキテクチャです。 PCIe は容量の回避策です。PCIe は同じメモリプール、レイテンシ、転送経路を作りません。 ローカル AI GPU コンテキストガイド は、モデルの重み、KV キャッシュ、ツール出力、ランタイムバッファをまとめてサイズ設定する理由を説明します。 Ollama Qwen3.8 27B GPU ベンチマーク も、長いコンテキストの結果を短いコンテキストのデコード値と分けて見る理由を示します。
判定
長いコンテキストで 27B 推論を行う目的では、16 GB の RTX 5060 Ti 2 枚は GB10 の代替として弱いです。 短いコンテキストサイズでは、より高いプロンプトスループットを提供します。GPU 電力も多く使い、ランタイムを分割メモリ構成に置きます。
提供された結果では、GB10 はプロンプト処理が遅いです。システムは電力効率が高く、合計メモリは 4 倍で、256K の Qwen テスト全体を実用的な生成速度で完了します。
短いプロンプトを使い、プロンプト取り込みを重視するなら、5060ti-x2 には限定的な用途があります。27B モデルでは、モデルとコンテキストが 1 つのコヒーレントなワーキングセットを共有するため、大きな統合メモリプールが適しています。PCIe 転送が推論経路に入ると、統合メモリが有利です。
このベンチマークは、RTX 5060 Ti 2 枚で Qwen 3 27B を決して起動できないことを示していません。モデルを起動することと、ワークロードを良好に実行することが違うと示しています。
ベンチマークの限界
提供されたレポートは Ollama の文字どおりのタグを示しますが、解決されたマニフェストのダイジェスト、モデルのリビジョン、CPU、電力測定、冷却構成は記録していません。また、5060ti-x2 システムの PCIe Gen4 x16 と、テスト時点の NVIDIA Linux ドライバを示しています。数値は観測したシステム比較として扱ってください。すべての RTX 5060 Ti 2 枚構成とすべての GB10 実装の普遍的な順位ではありません。
上記のハードウェア仕様は NVIDIA によるものです。性能値はこの記事に提供されたベンチマークデータによるものです。
参考資料
- Ollama Qwen3.8 モデルライブラリ
- Ollama GPT-OSS モデルタグ
- 深刻なローカル LLM 作業に 16GB VRAM は十分か
- Qwen 27B 用 32GB VRAM
- ローカル AI GPU コンテキストガイド
- Vast.ai の Qwen3.8 27B GPU ベンチマーク
- 16 GB RTX 5060 Ti 2 枚の完全なワークステーション掲載
- NVIDIA DGX Spark 米国マーケットプレイス掲載
- AMD Ryzen AI Halo 128 GB Linux 掲載
- Tom’s Hardware の Strix Halo 対 GB10 レビュー
- RTX 5060 Ti の現在価格
Related Posts