AIサイバーセキュリティ認定資格は実務に追いついていない

Table of Contents
試験を受け、合格しました。認定証は手にしましたが、私は具体的に説明したい失望も感じました。
これはプログラムを作った人々への批判ではありません。彼らは不完全な資料をもとに取り組んでいます。AIセキュリティはまだ新しい分野です。攻撃研究は防御ツールより速く進んでいます。ガバナンスフレームワークはエンジニアリングの指針より先に登場しました。
問題は、認定資格で学ぶ内容と、本番環境のAIシステムを実際に守るために必要な知識との間に隔たりがあることです。
混同されがちな3つの層
不足しているものを説明する前に、現在あるものを分けて考えると理解しやすくなります。
第1層はガバナンスです。NIST AI Risk Management Framework(AI RMF 1.0、2023)、ISO/IEC 42001:2023、EU AI Actなどの文書は、組織とプロセスのレベルで機能します。AIリスクの管理、監督体制の構築、説明責任の記録方法を説明します。意図的に、具体的な制御策の指定ではなくガバナンスに重点を置いています。これは設計上の選択です。
第2層は脅威の分類です。MITRE ATLASは、ATT&CKと同じ形式でAIシステムに対する敵対的な戦術を記録します。OWASP Top 10 for Large Language Model Applicationsは、導入済みのLLMに最も関連する攻撃の種類を列挙します。これらの文書は攻撃に名前を付け、その仕組みを説明します。防御策は規定しません。
第3層は技術的な指針です。Google’s Secure AI Framework(SAIF)、Microsoft’s AI Security SDL、OWASP AI Exchange、NIST AI 600-1(Generative AI Profile)、Anthropic、OpenAI、Metaなどのベンダー固有のセキュリティ文書が含まれます。安全な導入、評価手法、実行時制御に関するエンジニアリングレベルの指針を提供します。
ほとんどのAIガバナンス認定資格は第1層を詳しく扱います。第2層は概要レベルで触れます。第3層を扱うことはほとんどありません。
認定資格が扱う内容
現在取得できるAIガバナンスおよびセキュリティ認定資格には、IAPP AI Governance Professional(AIGP)、ISACA AI Fundamentals Certificate、ISO 42001認定資格、CompTIA AI+などがあり、共通するテーマを扱います。
NIST AI RMFと、その4つの機能であるGovern、Map、Measure、Manageを自組織のAI導入にどう対応づけるかを学びます。EU AI Actのリスク区分と、高リスクシステムの適合性評価について学びます。偏り、公平性、透明性、説明責任をガバナンス原則として学びます。AIガバナンスポリシーの作成や影響評価の実施方法も学びます。
これらは実際に役立つスキルです。組織にはガバナンスフレームワークを理解し、NIST AI RMFを読んで何を構築するよう求められているか把握できる人材が必要です。
認定資格が同じ深さでは教えない内容は次のとおりです。
- 攻撃者が本番環境のAIシステムを現在どのように侵害するか
- プロンプトインジェクションに対する多層防御が実務でどう機能し、単一の制御策ではなぜ完全に防げないか
- 導入前にモデルの完全性をどう検証するか
- AI固有のレッドチーム演習に何が含まれ、範囲をどう定めるか
- リリース前に敵対的入力に対するモデルの動作をどう評価するか
- 推論時のAIオブザーバビリティとは何か
- AIインシデント対応が標準的なIRプレイブックとどう異なるか
- ツールへのアクセスや外部連携を持つAIエージェントを守るために何が必要か
NIST AI RMFはガバナンスであり、エンジニアリングではない
NIST AI RMFはよく構成された文書です。NISTは、技術に中立で、業界に依存せず、さまざまなAI開発手法に適用できるよう設計しました。そのため幅広い用途に対応できます。
一方で、特定の攻撃に対する技術的な制御策は規定していません。組織がAI RMFを全面的に採用し、そのすべての機能をAI導入に対応づければ、文書化されたリスクプロセスは整います。しかし、導入済みの言語モデルに対するプロンプトインジェクション防御が整うとは限りません。
NISTもこの点を認めています。2024年に公開されたNIST AI 600-1(Generative AI Profile)は、生成AIと大規模言語モデル向けにAI RMFを拡張します。プロンプトインジェクション、データポイズニング、情報上の危険などを、基本のAI RMFより具体的に扱います。認定資格でAI 600-1を学ばず基本のAI RMFだけを扱ったなら、現在導入されているシステムに最も関連する文書を見落としています。
ISO 42001とマネジメントシステムの比較
ISO 42001:2023はAIマネジメントシステム規格です。組織レベルでAIの開発と導入を管理するための構造を提供します。セキュリティ専門家には、情報セキュリティのISO 27001との共通点が見えるでしょう。
ISO 27001は広く採用されています。それでも認証組織は侵害されます。認証が記録するのは、マネジメントシステムが存在し、定められたプロセスに従い、レビューされていることです。そのプロセスが管理するシステムが攻撃に耐えることを証明するものではありません。
ISO 42001は組織の規律を整えます。認証は、AIプロセスが文書化され、レビューされ、ガバナンス下にあることを関係者に示します。しかし、導入済みのモデルが敵対的な条件でも一貫した出力を返すこと、エージェントが定められた信頼境界内で動くこと、ファインチューニング済みモデルが検証済みの訓練データから作られたことまでは証明しません。
ISO 27001にも同じ隔たりがあります。従来のサイバーセキュリティでは、この限界を受け入れてきました。同じ構造的な制約を持つAIガバナンス認定資格が、その隔たりを埋めると主張すべきではありません。
EU AI Actは成果を求めるが、技術仕様は定めない
EU AI ActはAIシステムをリスクレベルで分類します。許容できないリスク(禁止)、高リスク(適合性評価が必要)、限定的リスク(透明性義務)、最小リスク(特定の要件なし)です。
重要インフラ、生体認証、採用選考、教育、法執行などに使われる高リスクシステムには、技術文書、人間による監督、堅牢性の要件があります。同法は、高リスクAIシステムが敵対的操作による振る舞いの変更に耐えることを明示的に求めています。
この要件は法文に記載されています。同法は意図的に技術的制御ではなく成果を定めています。あらゆる導入環境で敵対的な操作への堅牢性を示す方法は、システムの種類や用途ごとにまだ合意されていません。
EU AI Actに基づく認定資格は、AIシステムの分類、技術文書の作成、監督プロトコルの構築を教え、監査への備えを支援します。しかし、堅牢性要件に適合するシステムを作るエンジニアリング作業は、現在の認定資格が扱う領域とは別の分野です。
AIシステムを実際に攻撃するもの
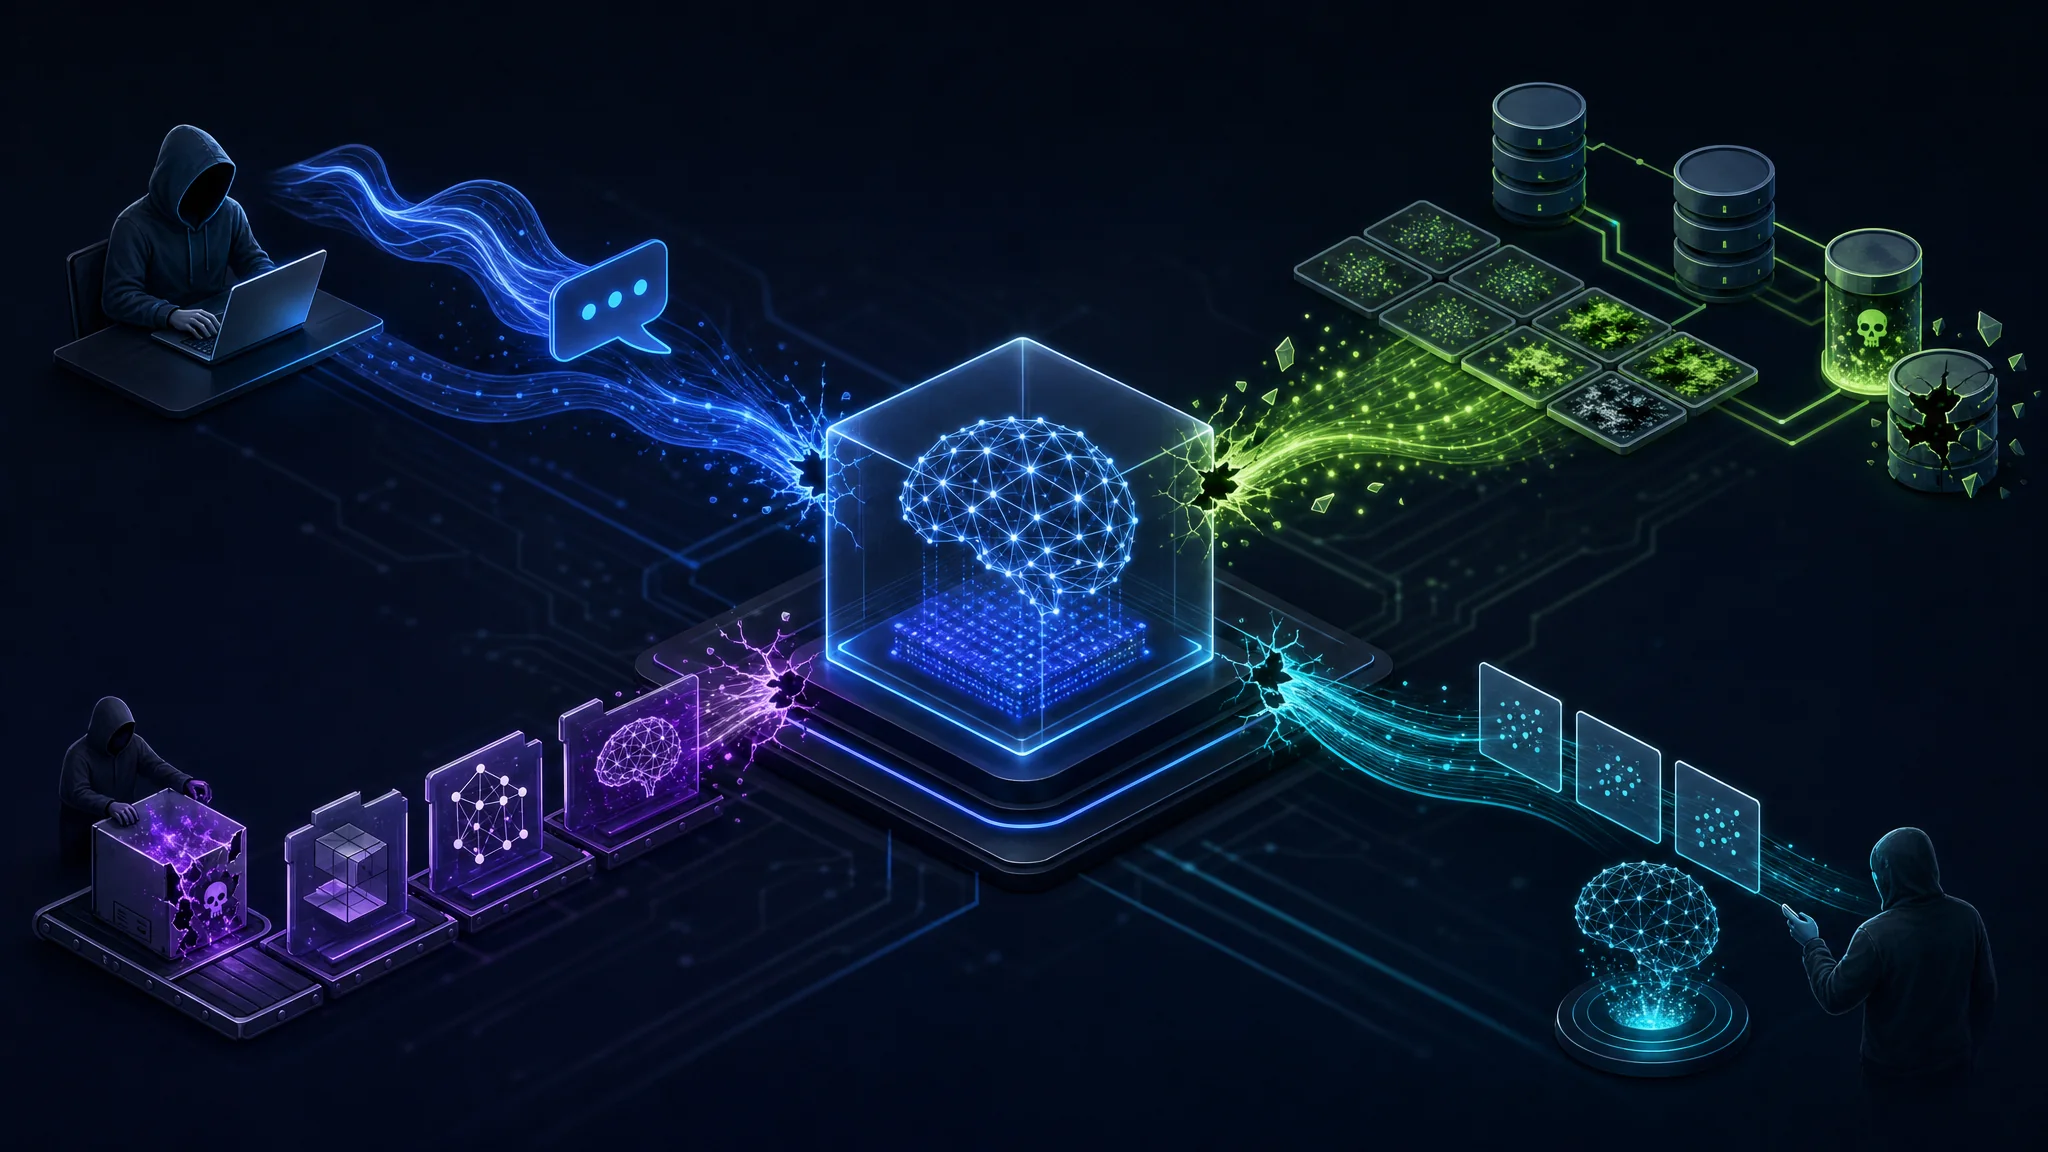
MITRE ATLASとOWASP LLM Top 10は、実運用上の脅威を文書化しています。これらの資料は有用な詳細さで攻撃を列挙します。ガバナンスフレームワークでは、脅威をより抽象的に扱います。以下はセキュリティ専門の資料に基づいています。
プロンプトインジェクションは、システム指示を上書きまたは操作する入力を言語モデルに与える攻撃です。直接インジェクションはモデルの入力を直接狙います。間接インジェクションは、モデルが取得、処理、要約する内容の中に悪意ある指示を埋め込みます。RAGパイプラインが攻撃者の管理する文書を読み、隠された指示を実行します。ブラウザーエージェントが攻撃者の管理するページにアクセスし、埋め込まれた指示に従います。カスタマーサポートボットが安全ガイドラインを無視するよう指示された記事を要約します。
2026年時点で、プロンプトインジェクションに対する万能な緩和策はありません。多層防御は、入力フィルタリング、出力検証、権限を制限したツールの範囲、サンドボックス化された実行環境、重大な操作に対する人間の承認によってリスクを下げます。どの対策も攻撃の種類を完全にはなくしません。NIST、OWASP、Anthropic、OpenAI、Google、Microsoftはいずれも単一の解決策ではなく、層状の制御を推奨しています。
訓練データのポイズニングは、モデルの動作を劣化させ、バックドアを仕込み、トリガーに反応する挙動を埋め込むため、訓練データに悪意ある例を混入させます。モデルが特定のトリガー入力を受け取るまで、ポイズニング成功の兆候が現れないことがよくあります。組織がユーザー生成コンテンツ、取得文書、第三者データセットを使ってモデルをファインチューニングし、その出所を検証しない場合、このリスクにさらされます。
モデルのサプライチェーン侵害は、多くの組織が後回しにする脅威です。モデルリポジトリは、モデルの重みとともに実行可能コードを配布することがあります。pickleのような安全でないシリアライズ形式は、繰り返しサプライチェーンのリスクを生んできました。モデルのダウンロードに付属するパッケージが、脆弱な依存関係をインストールする場合もあります。多くの組織は公開リポジトリのモデルを、ソフトウェア依存関係より大幅に甘く審査しているようです。攻撃対象領域はnpmに匹敵しますが、モデルを取り巻くセキュリティ文化はまだ初期段階です。
モデル抽出では、攻撃者がAPIに推論クエリを繰り返し送り、機能的に類似したモデルを再構築します。知的財産の損失につながるだけでなく、モデルをオフラインで調べ、より標的を絞った攻撃を開発できるようになります。
メンバーシップ推論では、特定のデータ記録が訓練セットに含まれていたかどうかを、モデルのアーキテクチャや訓練方法に応じた確信度で推測できます。個人情報を使って訓練した組織には、プライバシーリスクが生じます。
敵対的入力は、巧妙に作られた摂動によってモデルの出力を操作します。この手法は画像分類で最も研究されていますが、テキスト、音声、マルチモーダルシステムにも当てはまります。不正検知、信用力、医用画像、物理アクセスについてAIが判断するなら、敵対的な操作への堅牢性は文書化するだけでなく、検証すべきセキュリティ特性です。
AIシステムを通じたデータ漏えいには直接的な注意が必要です。RAGパイプラインはナレッジベースの文書を、本来アクセス権がないユーザーに見せることがあります。システム指示からのプロンプト漏えいは、機密にする予定だった運用情報を明らかにします。マルチテナントAI導入には分離が必要ですが、従来のアプリケーションセキュリティ担当者はその要件を過小評価することがあります。これらは本番システムで定期的に見られる運用リスクです。
AIエージェントは攻撃対象領域を大きく変える
AIセキュリティ認定資格の多くは、AIシステムが主にチャットボットや分類器を意味していた時期に作られました。2026年のエンタープライズAIは、ますますエージェントを意味するようになっています。
エージェントは、運用上重要な点でチャットボットと異なります。行動を起こすことです。メール、社内データベース、ファイルシステム、ブラウザー、コード実行環境にツール経由でアクセスできるエージェントは、機能を追加したチャットボットではありません。言語モデルの出力に基づき、実際のシステムへ大きなアクセス権を持って動く自律プロセスです。
OWASPは、エージェントの脅威モデルがLLMチャットアプリケーションと十分に異なり、別の文書が必要なため、Agentic AI Top 10を個別に管理しています。
エージェント環境のプロンプトインジェクションは、望ましくない文章の回答ではなく、望ましくない行動を引き起こします。取得文書に含まれる間接的な指示が、ファイル削除、データ持ち出し、メール送信をエージェントに命じることがあります。問題は不適切な回答ではなく、エージェントがアクセスできるシステム上で許可されていない操作を実行することです。
エージェントの攻撃対象領域には次が含まれます。
- ツール呼び出しの制限: 各タスクに適した最小限のツールにエージェントを制限しているか
- 認証情報の範囲: エージェントの認証情報を各タスクに必要な範囲に制限しているか
- 操作の可逆性: 重大な操作の実行前に人間の承認を必要としているか
- 出力フィルタリング: 後続操作を引き起こす前にエージェントの出力を検証しているか
- サンドボックス: 実行環境が接続先システムへの意図しないアクセスを防いでいるか
ほとんどのAIガバナンス認定資格は、これほど具体的なエージェントのセキュリティ設計を扱いません。
Model Context Protocolは新たなエンタープライズ攻撃対象領域を生む
Model Context Protocol(MCP)は、AIエージェントを外部ツール、データソース、サービスに接続する標準として広く採用されています。MCPサーバーはエージェントが発見して使用する機能を公開します。統合は速く柔軟ですが、セキュリティへの影響に同じ注意が払われるとは限りません。
MCP固有のリスクには次があります。
- 能力を偽って説明し、意図しない操作を実行する悪意あるMCPサーバー
- 正規のMCPサーバーが攻撃者の管理するデータを返し、本来データであるはずの出力に指示を埋め込むツールポイズニング
- MCP統合がタスクに必要な範囲を超える権限を持つ、過剰な権限のツール
- 接続されたMCPツールからの指示を、ユーザーの指示と同等に扱う信頼境界の混同
MCP統合を持つエージェントを導入する組織には、MCPサーバーの信頼性評価、ツール権限の監査、ツール応答が指示ではなくデータとして扱われることの検証を行うフレームワークが必要です。
評価は認定資格が省いている実務
AIレッドチーム演習と評価スイートは、導入前後のAIモデルリスクを理解するための主要な方法として、静的なセキュリティ評価に取って代わりつつあります。
AIレッドチーム演習には次が含まれます。
- 既知の攻撃手法に対するモデル動作の体系的な敵対的テスト
- 確立されたプロンプト攻撃データセットを使ったジェイルブレイクのベンチマーク
- 摂動された入力による出力の変化を測る敵対的堅牢性テスト
- モデルバージョン間の動作回帰テスト
- 公開済み評価スイートを使った安全性ベンチマーク評価
NIST、Anthropic、OpenAI、Microsoft、Google、CISAはいずれも、高リスクシステムの導入前にAI固有のレッドチーム演習を推奨しています。これは任意ではなく、標準的な期待になりつつあります。
現在のAIガバナンス認定資格には、導入済みのモデルやエージェントに対するレッドチーム演習の範囲を定め、実施し、結果を解釈するために十分な準備を提供するものがありません。レッドチーム演習とは何かは説明しても、実施方法は教えません。
AIオブザーバビリティは独立した分野
従来のセキュリティログはAIシステムにそのまま適用できません。本番環境のLLMやエージェントを監視するには、異なるデータ収集と分析が必要です。
AIオブザーバビリティ基盤には次が含まれます。
- 異常検知とポリシー違反の特定に使うプロンプトと出力のテレメトリー
- エージェントのツール呼び出しログ。呼び出したツールと引数を記録
- RAGパイプラインの検索品質監視
- ジェイルブレイクの試行の検知と分類
- モデルバージョン間のドリフト検知に使う出力一貫性の監視
- 事実の正確さが重要なアプリケーションにおける幻覚率の追跡
- コンテキストを膨らませるプロンプトインジェクションの試行を示す可能性があるレイテンシパターン
これは新興分野です。2026年にAIを導入する組織の多くは、従来のインフラよりAIコンポーネントの可観測性が大幅に低い状態です。ほとんどのガバナンス認定資格は、AIシステムに必要な適切なオブザーバビリティを説明しません。
AIインシデント対応は通常のIRとは異なる
従来のシステムが侵害された場合、IRプレイブックは封じ込め、フォレンジック、復旧を扱います。AIインシデントは標準的なプレイブックにない疑問をもたらします。
必要になる前に、次の疑問に備えたプレイブックを用意してください。
- ファインチューニング中にモデルがポイズニングされたか、どう判断するか
- RAG検索が悪用され、攻撃者の管理するコンテンツを返したか、どう評価するか
- エージェントが許可されていない操作を実行したか、またその範囲をどう特定するか
- 第三者プロバイダーのモデル更新が、セキュリティ上重要な形で動作を変えたか、どう検証するか
- インシデント前のモデル動作をどう記録し、発生後の動作と比較するか
こうした対応にはインシデント前の準備、事前に設定したログとテレメトリー、ネットワーク通信やエンドポイントログだけでなくモデル動作のフォレンジックも扱うAI固有のランブックが必要です。
認定資格の更新問題
認定資格が実務に遅れる構造的な理由の1つは、AIセキュリティの変化が認定更新サイクルより速いことです。
Security+、CISSP、ISO 27001が扱う領域は、何年もかけて変化します。ネットワーク、エンドポイント、アプリケーションの主な攻撃対象領域は比較的安定しています。AI攻撃技術は数か月単位で進化します。2026年のプロンプトインジェクション手法、敵対的攻撃方法、エージェント型の攻撃対象領域は、最初のAI認定資格が登場した2023年と2024年当時とは異なります。
認定機関は定期的に教材を更新します。OWASP LLM Top 10は最初の1年以内に大幅な改訂を公開しました。現在のAI認定資格の多くが設計された頃、MCPはエンタープライズの懸念事項ではありませんでした。エージェント型AIセキュリティのフレームワークは、現在のほとんどのカリキュラムより後に登場しました。
これは構造上の問題であり、意図の不足ではありません。認定資格を固定された知識体系と考えず、一次資料を継続的に読んでください。
AIセキュリティ認定資格の内容に必要なもの
認定カリキュラムが現在のAIセキュリティ実務を反映するには、次を扱う必要があります。
- プロンプトインジェクションへの多層防御: 入力フィルタリング、出力検証、ツールの範囲制限、サンドボックス、人間の承認、各対策に記録された限界
- モデルのサプライチェーン検証: 安全でないシリアライズのリスク、SBOM要件、来歴文書、署名済み成果物の検証
- AIエージェントのセキュリティアーキテクチャ: 信頼境界、最小権限のツールアクセス、操作の可逆性、監視要件
- MCPと外部連携のセキュリティ: ツールサーバーの信頼性評価、ツール権限の監査、データと指示の分離
- 評価とレッドチーム演習: 敵対的評価の範囲の定め方、利用可能なベンチマークと評価データセット、結果の解釈
- AIオブザーバビリティ: AIシステムに必要なログとテレメトリー、インシデント検知と対応への活用
- AI固有のインシデント対応: AIインシデントの事前計画、モデル動作に関する証拠の収集、AI固有の復旧上の検討事項
- データ漏えい防止: RAGの分離、プロンプトの機密性、マルチテナントアクセス制御、出力フィルタリング
今すぐ行うこと
組織のAIシステムを担当している場合:
OWASP Top 10 for Large Language Model ApplicationsとOWASP Agentic AI Top 10を読んでください。無料で、現在の有料認定カリキュラムより運用面の具体性があります。
AIコンポーネントの次回の脅威モデリングに先立ち、MITRE ATLASを確認してください。導入設計を確定する前に、自分のアーキテクチャに適用される攻撃者の戦術を把握してください。
NIST AI 600-1を読んでください。基礎のAI RMFを生成AI向けに拡張しており、LLMやエージェントの導入には基礎フレームワーク単独より大きく関連します。
Google SAIF、Microsoft’s AI SDL、OWASP AI Exchangeを確認し、ガバナンスフレームワークが提供しないエンジニアリング指針を得てください。
組織が導入するモデルの来歴をすべて検証してください。モデルカードを確認してください。重みを読み込む前に、シリアライズ形式に既知の悪用クラスがないかスキャンしてください。
環境内のすべてのAIエージェントについて、保有するアクセス権を整理してください。社内ナレッジベース、メール、ファイルシステムへの読み書き権限を持つエージェントは、プロンプトインジェクションの影響を増幅します。各タスクに必要な認証情報だけに制限してください。
重大な影響を伴う環境にモデルやエージェントを導入する前に、AI固有のレッドチーム演習を必須にしてください。任意ではなく必須として扱ってください。
必要になる前に、AI固有のインシデント対応ランブックを作成してください。
ガバナンス認定資格はプロセス層の文書と考えてください。セキュリティ態勢の文書ではありません。
参考資料
- NIST AI Risk Management Framework (AI RMF 1.0), 2023
- NIST AI 600-1: Generative AI Profile, 2024
- NIST SP 1270: Towards a Standard for Identifying and Managing Bias in Artificial Intelligence
- ISO/IEC 42001:2023 Artificial Intelligence Management Systems
- EU AI Act, Regulation (EU) 2024/1689
- OWASP Top 10 for Large Language Model Applications, 2025
- OWASP Agentic AI Top 10
- OWASP AI Exchange
- MITRE ATLAS: Adversarial Threat Landscape for AI Systems
- Google Secure AI Framework (SAIF)
- Microsoft AI Security SDL documentation
- CISA Guidance on AI Cybersecurity, 2024
- Barreno et al., Can Machine Learning Be Secure?, 2006
- Biggio et al., Poisoning Attacks Against Support Vector Machines, 2012
- Goodfellow et al., Explaining and Harnessing Adversarial Examples, ICLR 2015
- IAPP AI Governance Professional (AIGP) program documentation
- ISACA AI Fundamentals Certificate program documentation

Related Posts