ハイブリッドAIエージェントフリートの内部:Hermes、LiteLLM、Tailscale

Table of Contents
リクエスト単位でローカルGPUを割り当てるフリートを展開し、ハイブリッド制御プレーンを設計しました。 検証済みの経路はLiteLLMから始まり、モデルグループを選択し、一度に1台のGPUへローカルモデルをロードします。Hermesの階層ポリシーは提案段階です。Tailscale Apertureの設定成果物は次の統合テストに向けて準備済みです。どちらも単一のエンドツーエンド経路の一部としては検証されていません。
アイドル状態のカードはPearlをマイニングします。AIリクエストは貸し出されたカードだけでマイニングを一時停止し、リクエストに応答し、モデルをアンロードしてカードをマイナーに戻します。
要点
- T0〜T2は高コストまたは難度の高い作業を担当します。 これらの経路では、ホスト型フロンティアモデルと順序付けされたフォールバックチェーンを優先します。
- T3は大規模なローカル作業を担当します。 計画、コーディング、レビュー、ビジョンを4B〜12Bモデルに割り当てます。
- T4は頻度の高いローカル作業を担当します。 小型モデルがルーティング、分類、抽出、埋め込み、範囲を限定したコードタスクを処理します。
- 各GPUは独立したリソースです。 1枚のカードがAIを処理し、ほかのカードはマイニングを続けます。
- ローカルモデルはアイドル時にアンロードされます。 リクエスト時間帯の間、モデルがGPUメモリを占有しません。
- すべてのゲートウェイが同じ論理カタログを公開します。 共有エイリアスは適格なシステムへ作業を分散します。ノード接頭辞付きエイリアスは必要に応じて配置先を固定します。
- 実験用ブローカーは本番に入りませんでした。 Canaryはリクエストを処理しましたが、正常停止テストに失敗しました。LiteLLMは検証済みのリクエスト単位経路に残しました。
- HermesとApertureは準備段階です。 目標設計はありますが、エンドツーエンドの受け入れテストは未完了です。
前提条件: Linux GPUホスト複数台、安定したNVIDIAドライバー、Tailscale tailnet、systemd、稼働中のマイナー、モデル用ストレージ、各モデル経路の受け入れテスト。
時間と難易度: 上級。インベントリ作成、モデルのダウンロード、サービス定義、ルーティングテスト、障害訓練、カードごとのマイニング復旧確認に数日を見込んでください。
用語: tailnet はTailscaleのIDとデバイスで構成されるプライベートネットワークです。モデルエイリアスはクライアントに提示する安定したモデル名です。モデルグループは複数のデプロイを1つのエイリアスの背後にまとめます。プールプロキシはGPUを貸し出し、モデルワーカーを起動し、カードをマイニングへ戻す小さなローカルサービスです。
設計目標
エージェントの仕事にはさまざまな形があります。リポジトリの修復と、タイトル、スクリーンショット、埋め込み、意図ラベルでは必要なモデルが異なります。すべてのターンを最大モデルへ送ると費用とローカル容量を無駄にします。すべてを最小モデルへ送ると再試行が増え、結果の質も落ちます。
5つの負荷帯を持つ単一カタログを目指しました。既知のAPI形式を通じてホスト型モデルとローカルモデルを提供する必要がありました。ローカルGPUはAIリクエストの間も稼働させたかったのです。
フリートには並行処理も必要でした。複数カードを持つホストは、独立した仕事を同時に処理するべきです。1枚のカードへのリクエストが筐体内のすべてのカードのマイニングを止めてはいけません。
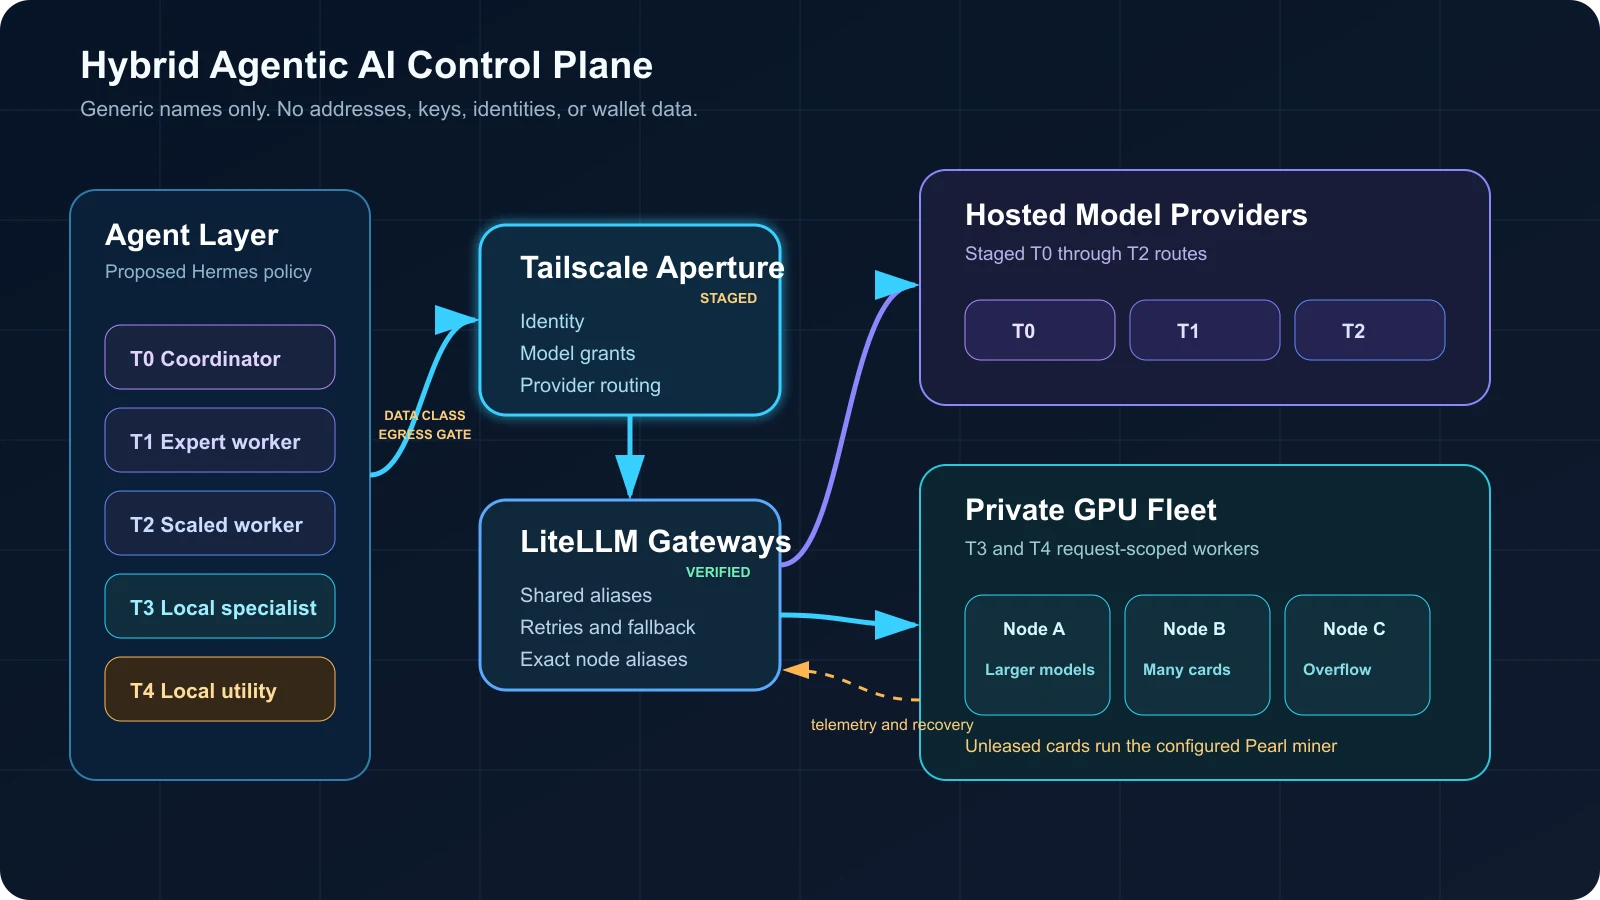
提案・準備中の制御経路は、検証済みのLiteLLMおよびGPU単位の実行経路の上位にあります
図では一般的なノード名を使っています。プライベートアドレス、ユーザーID、アクセスキー、ウォレット情報、物理ホストのラベルは含みません。
T0〜T4の意味
階層名は独自のルーティングポリシーです。業界標準ではなく、モデルのサイズだけを表すものでもありません。
| 階層 | 主な役割 | 主な接続先 | 障害時の動作 |
|---|---|---|---|
| T0 | デフォルトのコーディネーター、最難度の判断 | ホスト型フロンティア推論モデル | 順序付きホスト型フォールバックチェーン |
| T1 | 高価値なワーカーエージェント | 高性能なホスト型モデルプール | 割り当てられたチェーン内で再試行 |
| T2 | 広範なワーカーエージェントプール | エスカレーション可能な高速ホスト型モデル | 難しい作業をT1またはT0へ引き上げる |
| T3 | 大規模なプライベートローカル作業 | 4B〜12Bのローカルなチャット、コード、レビュー、ビジョンモデル | 適格なローカルノードで再試行し、制限データでは安全側に停止 |
| T4 | 限定的で頻繁なローカル作業 | 0.6B〜3Bのルーティング、分類、コード、埋め込みモデル | ローカルレプリカで再試行するか、同じデータ境界内のT3へ移行 |
階層はモデルより先に仕事を表します。セキュリティ上重要な短い分類はT4に合います。長いリポジトリ計画はT3以上です。難しいアーキテクチャ判断は、プロンプトが短くても高い階層から始めます。
この分割はエージェントの経済性も変えます。T4ワーカーは低リスクで反復的な変換を担います。T3ワーカーは一般的なコードと分析をtailnet内に保ちます。難しい作業と障害復旧にはT0〜T2を使えます。
ホスト型フォールバックの前にデータ分類ゲートを置きます。 公開、内部、制限対象の作業には別々のチェーンを使います。制限対象の作業はローカルに留め、失敗時は安全側に停止します。データ境界を越える再試行には、サニタイズ済みの入力とユーザーまたはワークフローの明示的な承認が必要です。ホスト型呼び出しの前に、資格情報、リポジトリの秘密、非公開のツール出力、機密性のある取得内容を削除します。
Hermesがタスクポリシーを担う方法
Hermesは提案中のエージェント層です。目標ポリシーはモデルクラスを割り当て、ツールを実行し、作業を委任し、明示的なフォールバックチェーンをたどります。Hermesはメインモデル、補助タスク、委任エージェント、タスク固有のフォールバックについて別々の経路を文書化しています。ベースURLを指定したOpenAI互換のカスタムエンドポイントもサポートします。 Hermes設定ガイド と フォールバックプロバイダーガイド を参照してください。
ポリシーは物理サーバーではなく、安定したエイリアスへHermesのタスクを割り当てます。例:
t3-smart
t3-code
t3-review
t3-vision
t4-code
t4-classify
t4-router
t4-embedding
エイリアスは意図を表します。Hermesは、空いているGPU、大きなカードを持つノード、ヘルスチェックに失敗したレプリカを知る必要がありません。これらの判断は下位レイヤーが担います。
一部の作業には決定論的な配置が必要です。ノード接頭辞付きモデルIDは、オペレーターの診断やベンチマークを選択したシステムへ送ります。Apertureの個別grantで、これらのエイリアスをオペレーターに限定します。通常のエージェント通信には階層ごとの共有エイリアスを使います。
モデルへのアクセスはエージェントのツールを保護しません。Hermesの展開には、最小権限のツール許可リスト、分離されたワークスペース、範囲を限定した資格情報、ネットワーク送信制御、プロンプトインジェクション対策が必要です。委任ワーカーには、担当タスクに必要な範囲を超える権限を与えないでください。
準備中のID境界としてのAperture
Tailscaleは各サービスを公開インターネットに出さず、設定済みのゲートウェイと推論ホストを接続します。Apertureはユーザー向けの境界とモデルルーターとして準備中です。この経路にはまだエンドツーエンドの受け入れテストが必要です。Tailscaleは 「Apertureの仕組み」 で、tailnet上の暗号化クライアントアクセスとTLSによるプロバイダー転送を説明しています。
Apertureは到達性と権限も分離します。grantはデフォルトで拒否します。ゲートウェイに到達した後、ユーザーまたはタグ付きデバイスには一致するモデルgrantが必要です。 Aperture grantガイド では、加算型のgrantモデルとIDソースを説明しています。
展開前に、準備中のAperture設定で次の4つのルールに従います。
- 管理者ロールを持つIDを1つ指定します。 一般的なモデルアクセスでは管理者権限を与えません。
- プロバイダーはモデルIDを文字列どおりに列挙します。 Apertureは上流サービスからモデルを推測しません。
- プロバイダーURLはtailnetアドレスを参照します。 プライベートノード名やアドレスを記事や公開設定例に含めません。
- 秘密情報はサービス所有のファイル内に保管します。 展開前に所有者限定の権限、制限されたサービスアカウント、ローテーション、ログの秘匿化を適用します。診断出力にLiteLLMキー、tailnetアドレス、サブスクリプショントークン、ウォレット情報を決して表示しません。
Apertureは各プロバイダーのベースURLに受信リクエストのパスを追加します。
設定リファレンス
は、プロバイダーのルートに重複した/v1を付けないよう警告しています。この点は統合リスクが高いため、明示的な検証項目にしました。
ビジョンは画像コンテンツ付きのOpenAI Chat Completions形式に対応する準備ができています。Apertureの現在のセルフホスト型プロバイダーマトリックスはチャット形式を記載していますが、埋め込み経路はチャット選択肢にないLiteLLMとllama.cppのエンドポイントに依存するため、埋め込みはプライベートなLiteLLMエンドポイントを直接使います。 サポート対象のプロバイダーとクライアントのリファレンス を参照してください。
直接接続する埋め込み経路には独自の認可境界が必要です。LiteLLM認証、制限的なTailscale grant、tailnetインターフェースへのサービスバインド、ホストファイアウォールルールにより、承認済みのIDまたはサービスタグだけにアクセスを制限します。プライベートアドレスだけでは認可ポリシーになりません。
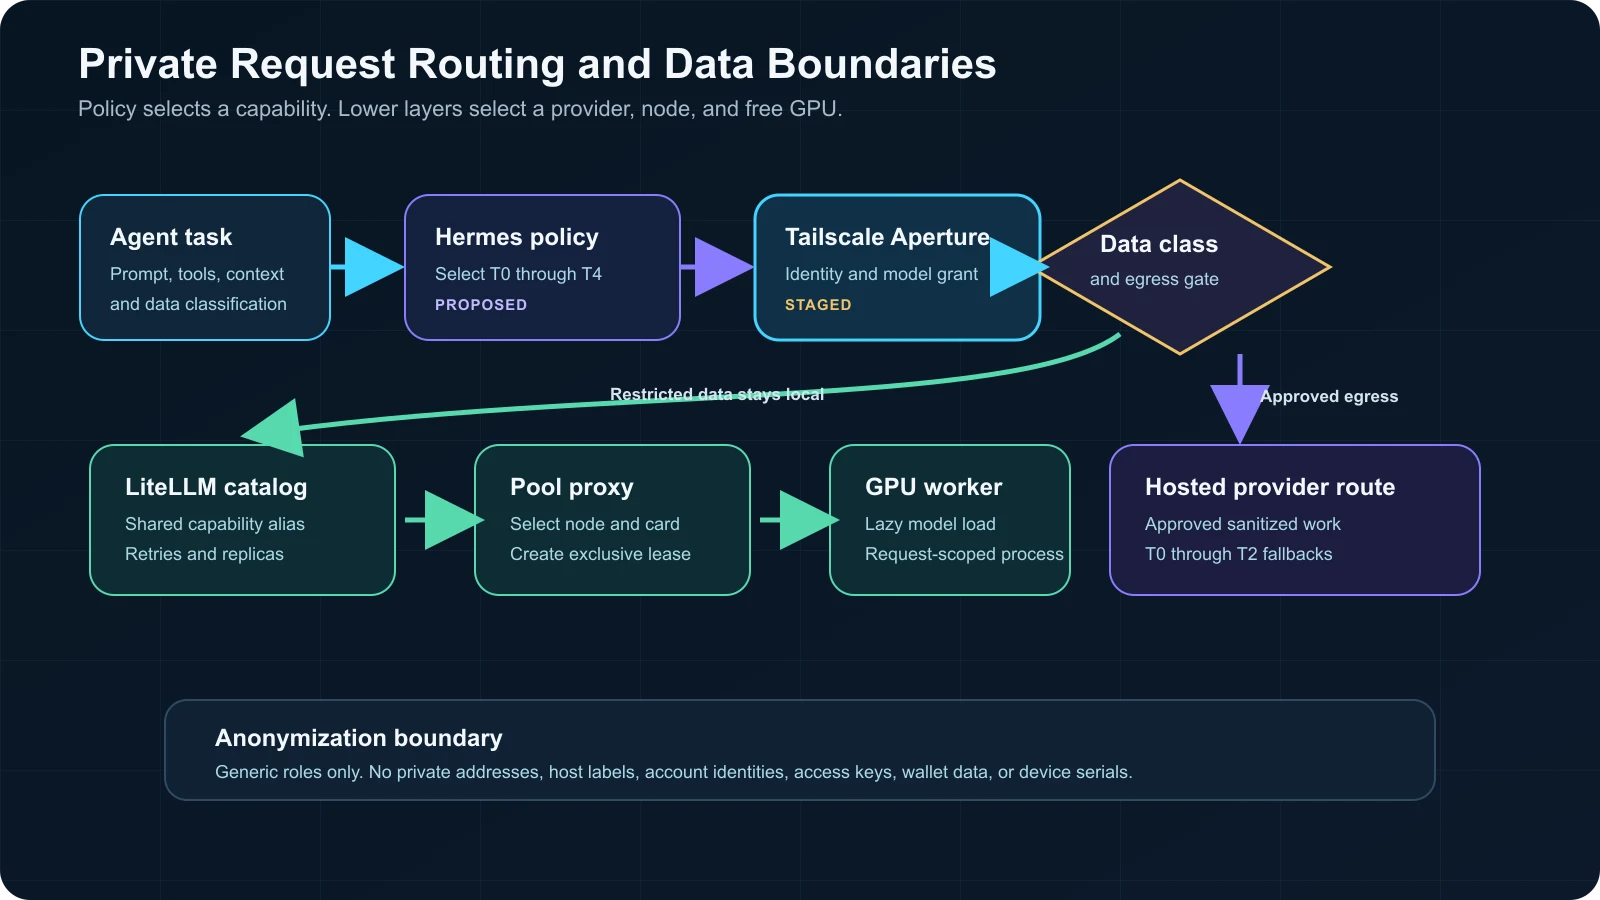
ID、grant、データ分類によってリクエストがプライベートフリートを離れるか決まります
LiteLLMが1つのカタログを提供
各推論ホストはLiteLLMゲートウェイを実行します。モデルが別ノードにあっても、すべてのゲートウェイが同じ論理モデルカタログを公開します。クライアントは1つのAPI形式とエイリアス一式を使い続けます。
LiteLLMは複数のデプロイを1つのモデル名にまとめます。ルーターは適格なデプロイを選び、再試行、タイムアウト、クールダウン、フォールバックを適用します。現在の LiteLLMルーティングドキュメント では、共有モデル名、ルーティング戦略、再試行の動作を説明しています。
カタログには2種類のアドレス形式があります。
| アドレス形式 | 例 | 用途 |
|---|---|---|
| 共有エイリアス | t4-classify | 通常の作業を適格なノードへ分散 |
| ノードエイリアス | node-b/qwen-small | 診断の実行または配置の固定 |
共有エイリアスはHermesを変更せずに水平スケールできます。適格なレプリカの追加でモデルグループを拡張し、異常なレプリカの除外で縮小します。
GPUのライフサイクル処理はLiteLLMより下位に置きます。ゲートウェイ自体はGPUメモリを確保しないため、起動状態を保てます。ローカルプールプロキシが選択されたモデルのリクエストを受け、カードを貸し出し、ワーカーを起動し、応答後に終了します。
ローカルモデルカタログ
フリートでは12B以下のモデルを優先します。この上限はカードのメモリに合い、コンテキストとランタイムバッファーの余地も確保します。
モデル表記: Bはパラメーター数の十億単位、Kは設定したコンテキストトークンの千単位です。量子化は数値精度を下げて重みを保存し、メモリ使用量を抑えます。KVキャッシュはアクティブなコンテキストの注意状態を保持し、プロンプトが長くなるほど増加します。E4Bは小型Gemma 4を示すGoogleのサイズ表記です。
| 階層ルート | モデルクラス | 設定コンテキスト | 主な用途 | 配置 |
|---|---|---|---|---|
| T3 smart | Qwen3.5 9B、量子化 | 64K | 難しいローカル計画、一般的なエージェント作業 | メモリ容量の大きいGPUノード |
| T3 code | Granite 4.2 8B、量子化 | 64K | リポジトリ作業、ツール、ターミナル、構造化出力 | メモリ容量の大きいGPUノード |
| T3 review | Gemma 4 12B、量子化 | 32K | 独立レビュー、別経路の推論 | メモリ容量の大きいGPUノード |
| T3 一般およびビジョン | Qwen3.5 4B、量子化 | 32K | 拡張可能な一般作業、画像理解 | すべての互換GPU |
| T3 alternate review | Gemma 4 E4B、量子化 | 8K | 多様なレビュー経路 | すべての互換GPU |
| T4 code | Granite 4.2 3B、量子化 | 16K | 小規模編集、ツール呼び出し、構造化出力 | すべての互換GPU |
| T4 classify | Qwen3.5 2B、量子化 | 16K | 分類、抽出、書き換え | すべての互換GPU |
| T4 router | Qwen3.5 0.8B、高精度量子化 | 16K | 意図、ラベル、タイトル、短い変換 | すべての互換GPU |
| T4 embedding | Qwen3 Embedding 0.6B、量子化 | 32K | エージェントメモリ、RAG、コード検索、クラスタリング | すべての互換GPU |
これらのコンテキスト値はデプロイ設定であり、モデルの公称上限ではありません。公称ウィンドウが大きくても、KVキャッシュとランタイムメモリを消費します。1枚のカードで安定稼働するよう、低めの値にしました。
QwenはQwen3.5をマルチモーダルファミリーと説明し、小型から大型までのdenseモデルを Qwen3.5コレクション で公開しています。IBMは Granite 4.2 8B のエージェント型コーディングと長文コンテキストの結果を公開しています。Googleは Gemma 4 について、マルチモーダル入力、関数呼び出し、より大きな公称ウィンドウを挙げています。
埋め込み経路では、チャットモデルにベクトルを求めず、専用モデルを使います。 Qwen3 Embedding 0.6Bのモデルカード には、32Kの系列長、多言語検索、コード検索、最大1,024次元の出力が記載されています。
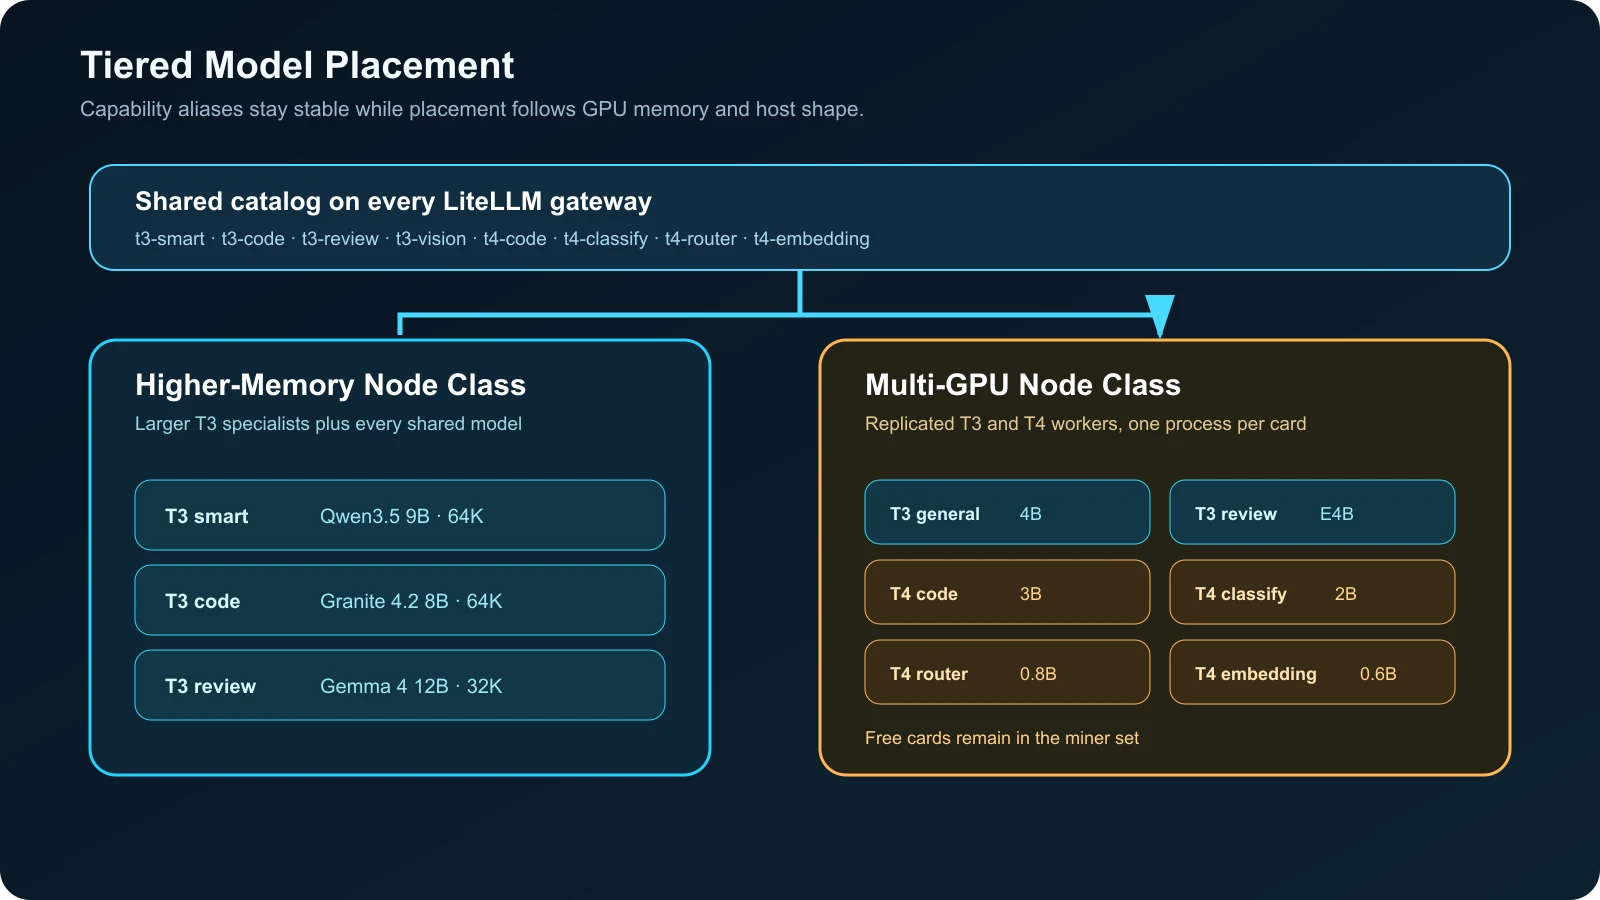
大型の専門モデルは容量の大きいカードに置き、小型モデルはフリート全体へ複製します
本番でllama.cppを使う理由
llama.cppはリソースモデルに合います。1つの静的ワーカーを、1台のGPU、1つのモデルファイル、1つの設定コンテキスト、1つのリースに対応させます。プロセス境界により、起動、終了、GPUの可視性、ログを監査しやすくなります。
サーバーはOpenAI互換のchat、responses、embeddingsを公開します。並列デコードと継続的バッチ処理にも対応します。現在のサーバードキュメントでは、マルチモーダル対応を実験的としています。詳細は llama.cppサーバードキュメント を参照してください。
Ollamaは大きなノード上で互換性経路として利用できます。メモリが収まれば複数モデルを同時にロードでき、
Ollamaのよくある質問
の説明どおりkeep_alive: 0で直ちにアンロードできます。カード単位の本番経路には選びませんでした。静的なllama.cppワーカーの方が配置と終了を細かく制御できたためです。
Strataも評価しました。StrataはGPUメモリ、システムRAM、ストレージにまたがる大規模なQwen mixture-of-expertsモデルを対象とします。公開プリセットは合計32 GBのメモリから始まり、low-RAMモードは速度と引き換えに容量を減らします。 Strataリポジトリ を参照してください。Strataは別の目的に合います。1台または複数カードで1つの大規模なハイブリッドモデルを動かす構成です。こちらのフリートでは12B未満の独立ワーカーを多数使います。
GPUごとの遅延読み込み
すべてのモデルワーカーに遅延読み込みを適用します。リクエスト間に稼働するのはゲートウェイ、プールプロキシ、watchdog、マイナーだけです。
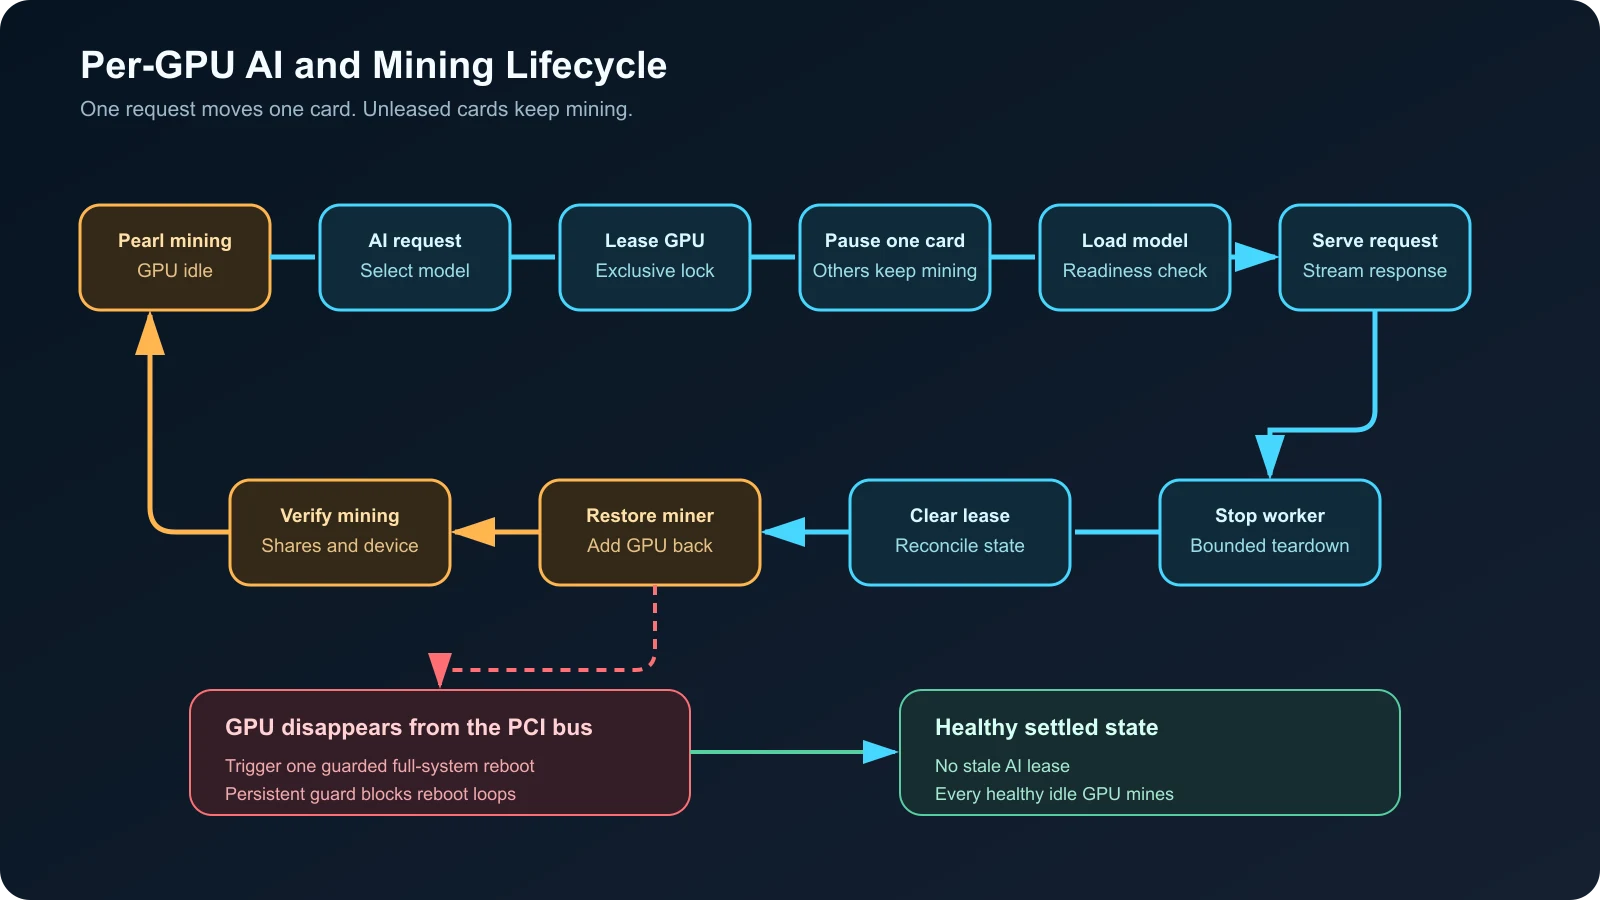
リース対象のカードだけがマイナーを離れ、モデルプロセスの終了後に戻ります
リクエストのライフサイクルは次のとおりです。
- LiteLLMがデプロイを選択します。 リクエストは選ばれたモデルクラスのプールプロキシへ届きます。
- プールがリースを取得します。 ロックにより、2つの専用ワーカーが同じカードを占有するのを防ぎます。
- マイナーはGPUを1台除いて再起動します。 リースされていないカードはすべてPearlコマンドに残します。
- llama.cppがリース対象デバイスで起動します。 プロキシがリクエストを転送する前に準備状況を確認します。
- ワーカーが応答を処理します。 並行リクエストは別の空きカードでワーカーを起動します。
- ワーカーが終了します。 プロセスの終了後、プールがリースを削除します。
- マイナーが解放されたGPUを含めて再起動します。 ヘルスチェックでカードがマイニングへ戻ったことを確認します。
これはホスト全体を一括で切り替える方式とは異なります。複数カードを持つ筐体では、ほかのカードがマイニングを続ける間に複数モデルを処理できます。アイドル時は、正常なGPUをすべてPearlへ戻します。
Pearlのホワイトペーパー では、行列計算の証明システムを説明しています。この設計は収益予測や経済的利益の主張に依存しません。マイニングは設定されたアイドル時の負荷です。
起動より障害対応が重要
モデルの起動はライフサイクルの半分にすぎません。強制終了、GPUの消失、リクエスト中断、古いリース、マイナーの再起動には明示的な対処が必要です。
watchdogは設定済みGPU集合とNVIDIAデバイスの現在の一覧を比較します。GPUの不在を確認すると、保護されたシステム全体の再起動を1回だけ実行します。本番の安全なトリガーには、複数回のチェック失敗、クールダウン、実行中ジョブの排出、永続的な再起動カウンター、リモート通知を要求します。復旧に失敗したら自動処理を停止し、手動介入を求めます。
同じwatchdogが古いリースも調整します。ワーカーがリースを保持していなければ、調整処理で古い記録を削除し、GPUをマイナーへ戻します。この復旧経路はブローカーのcanaryテストで重要でした。
| 障害 | 対応 |
|---|---|
| モデルの準備が整わない | ワーカーを停止し、リースを解放し、マイニングを復元してエラーを返す |
| リクエストが予期せず終了する | クリーンアップ時間を制限し、ワーカープロセスツリーを終了してリースを調整する |
| GPUが消える | 複数回の不在を確認し、稼働中の作業を排出し、保護された再起動を1回実行し、通知し、設定済みGPU集合全体を検証する |
| マイナーがアイドルカードを省く | アクティブなリースからデバイス一覧を再構築してマイナーを再起動する |
| LiteLLMのデプロイが失敗する | 同じモデルグループ内の別レプリカを試し、その後フォールバックポリシーに従う |
| Apertureのgrantが経路を遮断する | IDまたはモデルgrantを修正し、ゲートウェイポリシーを迂回しない |
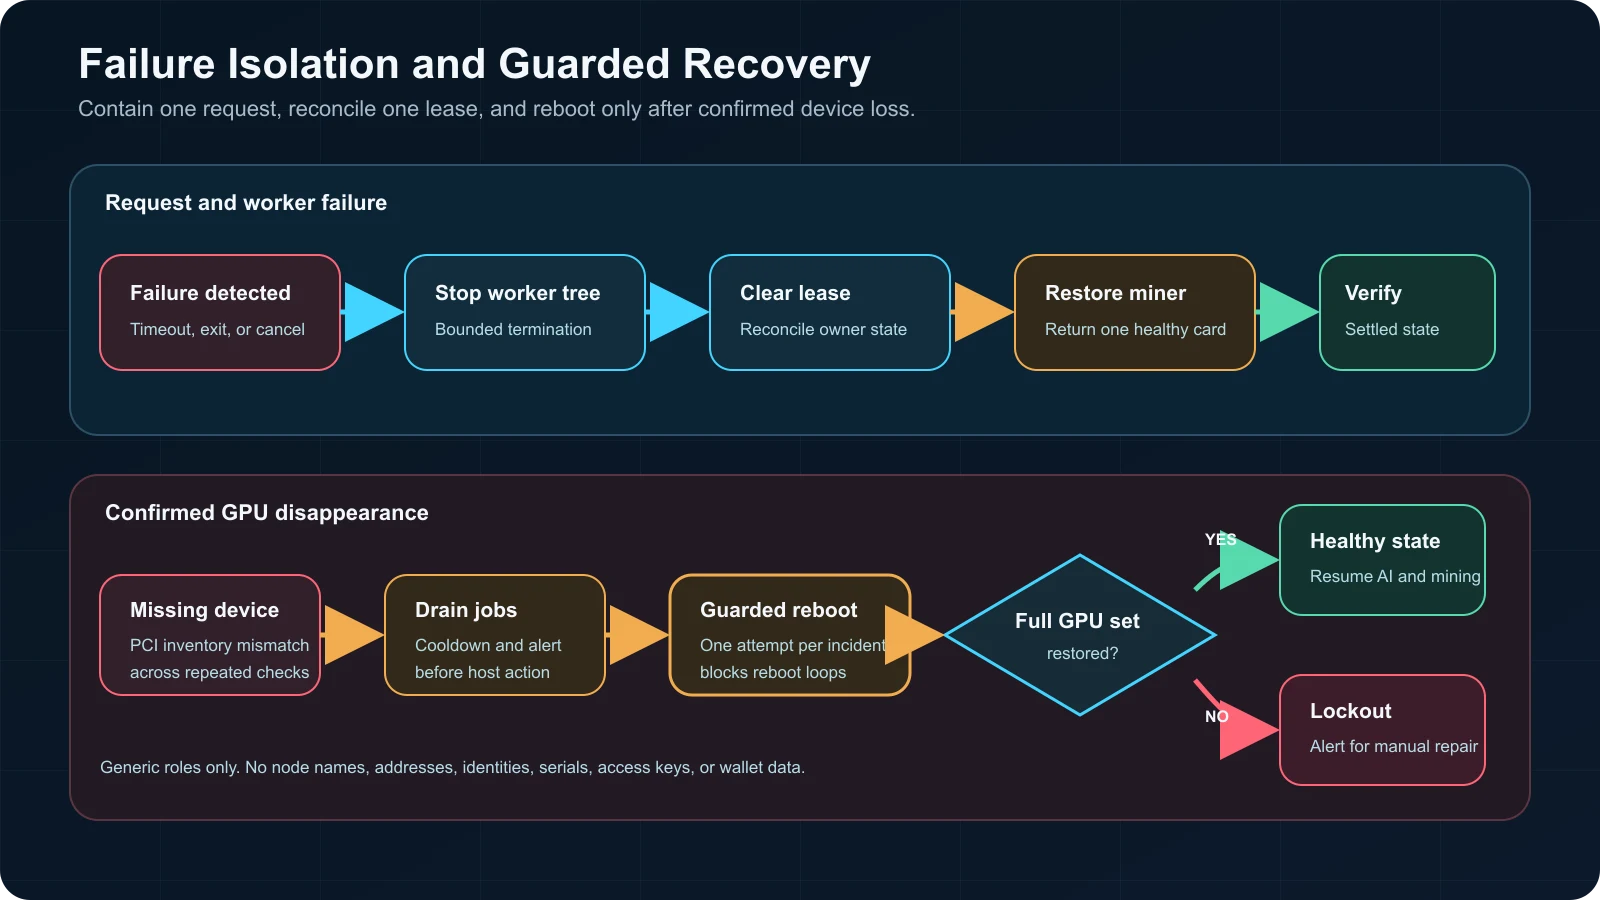
通常の障害では1つのリースを解放し、デバイス消失が確認された場合は保護されたホスト復旧経路を開始します
実験用ブローカーで起きたこと
バックエンドに依存しないブローカー は、Ollama、vLLM、llama.cpp、Strataの共通OpenAI互換インターフェースを目指します。モデル単位のライフサイクル管理、アイドル時のアンロード、GPU配置を備えます。
2026年10月21日に、commit c12b65のブローカーv0.6.0をテストしました。ローカルスイートは1,101件が合格、2件がスキップとなり、Ruffの問題はありませんでした。その後、canaryはモデルをオンデマンドでロードしてチャットリクエストを正常に処理しました。ほかのGPUはリクエスト中もマイニングを続けました。
停止時に重大なライフサイクル問題が見つかりました。モデルをロードした後、systemdがプロセスツリーを終了するまでブローカーの停止処理が終わりませんでした。強制停止によりGPUリースが残り、調整処理がマイナーを復元するまで解消されませんでした。また、必須GPUの設定に関する文書と、本番アダプターでの適用に差がありました。
本番経路からブローカーを無効にしました。 LiteLLMは現在、リクエスト単位のプールプロキシでルーティングします。子プロセスの時間制限付き停止、プロセスグループの終了、必須GPUの受け入れチェック、古いリースのクリーンアップが統合テストに合格するまで、ブローカーは実験用のままです。
ここから得られる技術的な教訓は明確です。モデルを一度起動しただけでは、ブローカーの価値はほとんど証明できません。本番対応には、正常な停止、制限時間内の復旧、排他的なデバイス割り当て、再現可能な障害訓練が必要です。
実施した検証
デプロイテストではモデルの応答以外も確認しました。
- 各共有チャットモデルが、適格なホスト1台以上でロード、応答、終了、Pearl復旧のサイクルを完了しました。
- ビジョン経路はチャット経由で画像入力を受け付けました。
- 埋め込み経路はプライベートなLiteLLM経由で設定済みのベクトルサイズを返しました。
- 複数のモデルが別々のカードで同時に動きました。
- 並行するAIリクエスト中も、リースされていないカードはマイナーに残りました。
- 共有エイリアスは適格なノード間でルーティングしました。
- ノード接頭辞付きエイリアスは決定論的な配置を維持しました。
- すべてのLiteLLMゲートウェイが同じ論理カタログを一覧表示しました。
- GPUの不在からホスト全体を1回再起動して復旧しました。watchdogには永続的なループ防止が追加されています。
- ブローカー停止の失敗から、リース調整で復旧しました。
- 最終安定状態ではAIリースがなく、正常なGPUはすべてマイナーへ戻っていました。
ヘルスチェックやモデル一覧をモデルロードテストとは見なしません。適切な受け入れテストは実際のリクエストを送り、応答を確認し、使用GPUを特定し、停止を観察し、マイニング復旧を確かめます。
フリートのトラブルシューティング
| 症状 | 最初の確認 |
|---|---|
| モデルが見えるのにリクエストが失敗する | 上流モデルID、API形式、認証ヘッダー、プロバイダーのベースURL |
| Apertureが405を返す | プロバイダーのルートに重複した/v1がないこと |
| 違うノードでリクエストが処理される | 共有エイリアスとノード接頭辞付きエイリアスの違い |
| 2つのワーカーが同じカードを使おうとする | リースロック、古いリース状態、GPU割り当てロジック |
| すべてのカードでマイニングが止まる | マイナー再起動コードがアクティブなリースからデバイス一覧を作ること |
| GPUがマイニングに戻らない | ワーカープロセスツリー、リース調整、マイナーのデバイス一覧 |
| コールドロードが遅い | モデルサイズ、ストレージ速度、PCIeリンク幅、ホストCPU負荷 |
| 長いプロンプトが失敗する | 設定コンテキスト、KVキャッシュ余裕、出力予約 |
| Apertureに埋め込み経路がない | Tailscale IDとホストファイアウォールで制限された認証済みLiteLLM経路を使う |
| ブローカー停止がハングする | ブローカー経路を無効にし、検証済みプールプロキシへ戻す |
維持したい設計ルール
- 作業目的でルーティングします。 モデルサイズだけでは階層を決めません。
- 配置より上位にポリシーを置きます。 Hermesは機能エイリアスを選び、LiteLLMはデプロイを選び、プールはGPUを選びます。
- GPUごとに独立したリースを扱います。 ホスト全体の切り替えは使えるカードを無駄にします。
- アイドルモデルはすべてアンロードします。 ウォームなゲートウェイにウォームなGPUワーカーは不要です。
- 制限された厳密配置の経路を残します。 オペレーター専用のノードエイリアスで診断を再現可能にします。
- 終了処理を先にテストします。 マイナー復旧とリースクリーンアップを受け入れテストに含めます。
- チャット、ビジョン、埋め込みを分けます。 1つのゲートウェイが1つのプロトコル経路を意味するわけではありません。
- 図からプライベート情報を除きます。 役割と流れを示し、アドレス、キー、ID、ウォレット情報を掲載しません。
- 再起動ロジックに保護を加えます。 繰り返しの不在、クールダウン、永続カウンター、アラート、復旧失敗後の手動介入を必須にします。
- 実験用の別経路を保ちます。 ブローカーの失敗で検証済み経路まで巻き込みません。
次のステップ
次は負荷の評価です。各階層には固定のタスクセット、受け入れ基準、遅延記録、GPU占有率、マイニング中断時間、エスカレーション率が必要です。計測結果から、どのT2タスクがT3向けで、どのT3タスクがT4に収まるか分かります。
また、HermesからAperture、LiteLLMを通る最初の受け入れテストを実施し、停止とGPU割り当てを修正した後にブローカーを再テストする予定です。画像生成を同じルーティングカタログに加える前に、遅延読み込み対応のOpenAI互換アダプターが必要です。
モデルのサイズ選びには ローカルAIモデルとGPUコンテキストのガイド を参照してください。プライバシー境界については ローカルAIのプライバシーとセキュリティ を読んでください。マイナーの設定とリスクについては、アイドル時のマイニングを確実な利益と見なさず、 Pearlマイニングガイド を確認してください。

Related Posts