本格的なローカル LLM 作業に 16GB VRAM は十分か
Table of Contents
16GB の専用 GPU メモリは、モデル、コンテキスト、ランタイムが収まれば、本格的なローカル LLM 作業を支えます。ウェイトを読み込めることは、最初の条件を満たすだけです。実用的な構成には、作業中の会話に必要なメモリと、タスクを終えるための速度も必要です。
1 ユーザーのコーディングまたは文書ワークフローの予算を考える例として Qwen3.8 27B を使います。まずタスクに必要なコンテキストを決め、残りのメモリに収まるウェイトとランタイム設定を選びます。ハードウェア仕様とモデルソースは 2026 年 10 月 7 日に確認しました。
要点
- 量子化を選ぶ前に、コンテキスト用のメモリを確保します。
- プロンプト処理を出力速度とは別に測定します。
- 使わないビジョンサポートを無効にし、8 ビット KV キャッシュを試します。
- 正確な GPU、バックエンド、モデルファイル、プロンプト長を比較します。
- ワークロードとプロバイダー料金から所有による節約を計算します。
予算計算には、ランタイムのメモリログ、正確なモデルファイル名、代表的なタスクが必要です。セットアップと結果の記録に約 20 分を見込み、推論時間は別に考えます。難易度は中級です。
メモリを作業に合わせる
16GB は、ウェイト、アクティブなコンテキスト、一時割り当てが利用可能な GPU メモリ内に収まるワークロードに適します。必要なコンテキストはタスクで変わります。短い文書要約と、数十個のファイルを読むコーディングエージェントでは予算が異なります。
| ワークロード | 最初に確認する質問 |
|---|---|
| 短いチャットまたは下書き | モデルは品質目標を満たしますか。 |
| 文書分析 | ソーステキストと回答は一緒に収まりますか。 |
| コーディングエージェント | ファイルとツール結果はどれだけコンテキストを消費しますか。 |
| 同時リクエスト | 各アクティブセッションにどれだけキャッシュが必要ですか。 |
設定したウィンドウと、実際に使うウィンドウは異なります。64K の上限と短いプロンプトを使うベンチマークは、会話が 55K トークンになった後の生成を測りません。ハードウェアを選ぶ前に、想定するセッション長の近くでテストします。
モデルが収まる理由
量子化は、少ないビット数でウェイトを保存します。 Bartowski の Qwen3.8 27B ファイル表 では、Q4_K_M は 17.44 GB です。これはランタイムメモリを含める前に、16 GiB デバイスの約 17.18 億バイトを超えています。
ISTA-DASLab の GSQ-RCO モデルカード では、IQ3_S は 11.8 GB です。この方式は、サイズ予算内でテンソルごとに異なる精度を割り当てます。オプションの MTP 版は約 0.35 GB、ビジョンプロジェクターは約 0.9 GB を追加します。
| 公開ベンチマーク | BF16 / IQ3_S スコア |
|---|---|
| AIME25 | 100.00 / 100.00 |
| LiveCodeBench v6 | 85.71 / 85.71 |
| GPQA-Diamond | 89.90 / 89.39 |
研究所はこの動作点を「task-lossless」と呼びます。ここで選んだ結果が支えるのは限定的な比較です。同一の回答、長いコンテキストで同じ検索結果、コーディングタスクで同じ信頼性を証明するものではありません。圧縮モデルを自分の受け入れ基準でテストしてください。
キャッシュを数える
KV キャッシュは、処理済みトークンのアテンションキーと値を保存します。プロンプト、ツール出力、生成された回答がコンテキストを消費します。ランタイムによっては起動時にキャッシュ容量を割り当てるため、表示メモリがメッセージごとに増えるとは限りません。
Qwen の設定 は、64 レイヤー、4 レイヤーごとのフルアテンション、4 個の KV ヘッド、256 のヘッド次元を指定しています。16 個のフルアテンションレイヤーの FP16 キャッシュコストは次の計算になります。
16 layers × 4 KV heads × 256 elements × 2 (K and V) × 2 bytes
= 65,536 bytes per token
= 64 KiB per token
この計算には、再帰状態、アラインメント、一時バッファ、投機的デコーディングの割り当てを含めません。別のアーキテクチャには別の計算が必要です。
| 使用中のトークン | FP16 フルアテンションキャッシュ |
|---|---|
| 32,768 | 2 GiB |
| 65,536 | 4 GiB |
| 131,072 | 8 GiB |
| 262,144 | 16 GiB |
ここでの KiB と GiB は 1024 の累乗です。モデルのダウンロードサイズは 10 進の GB です。単位を混ぜると残りの予算を誤ります。
利用可能なコンテキストを予算化する
長いテキストセッション用にメモリを空ける設定は 2 つあります。使わないビジョンプロジェクターを外し、キャッシュ精度を下げます。ロードしたモデルとランタイムの割り当てに対して効果を計算してください。
次の例では、すべての割り当てを 10 進 GB で表します。下の 1.0 GB の予約は計画上の仮定であり、ランタイムの普遍的な既定値ではありません。
| 割り当て | Vision on / vision off |
|---|---|
| Physical 16 GiB capacity | 17.180 / 17.180 GB |
| Model weights | 11.800 / 11.800 GB |
| Optional MTP head | 0.350 / 0.350 GB |
| Vision projector estimate | 0.930 / 0 GB |
| Assumed other allocations | 1.000 / 1.000 GB |
| Left for growing cache | 3.100 / 4.030 GB |
1 トークン 65,536 バイトでは、3.100 GB は約 47,300 トークンです。ビジョンを無効にすると、理想的な 8 ビット保存は 1 トークン 32,768 バイトになり、約 123,000 トークンを保持します。
実際の q8_0 保存にはブロックスケールが含まれます。32 個の値あたり 34 バイトの場合、この例では 1 トークン約 34,816 バイトが必要です。そのため見積もりは約 115,700 に下がります。追加割り当ては結果をさらに下げます。したがって、これらの仮定で約 110K は妥当な計画値であり、保証された設定ではありません。
残りのコンテキストは入力と出力の両方を収める必要があります。65,536 トークンのウィンドウ、例としての初期プロンプト 30,000 トークン、出力上限 8,192 トークンでは、ファイル、ツール結果、会話に 27,344 トークンが残ります。初期プロンプト予算は例です。自分のツールと指示を測定してください。
試す価値のある設定
llama.cpp サーバーのドキュメント は、キーと値のキャッシュ型、プロジェクターの自動ロード、並列スロットを別々に説明しています。テキストのみのワークロードでは、ビジョン無効、両方のキャッシュ型に q8_0、1 スロットを試します。最初は控えめなコンテキストにします。
コンテキストを増やす前に、得られた割り当てを記録します。キャッシュ量子化には、選択したアーキテクチャとバックエンドの対応が必要です。精度を変更した後に回答品質をテストします。比較用に動作する構成を残します。
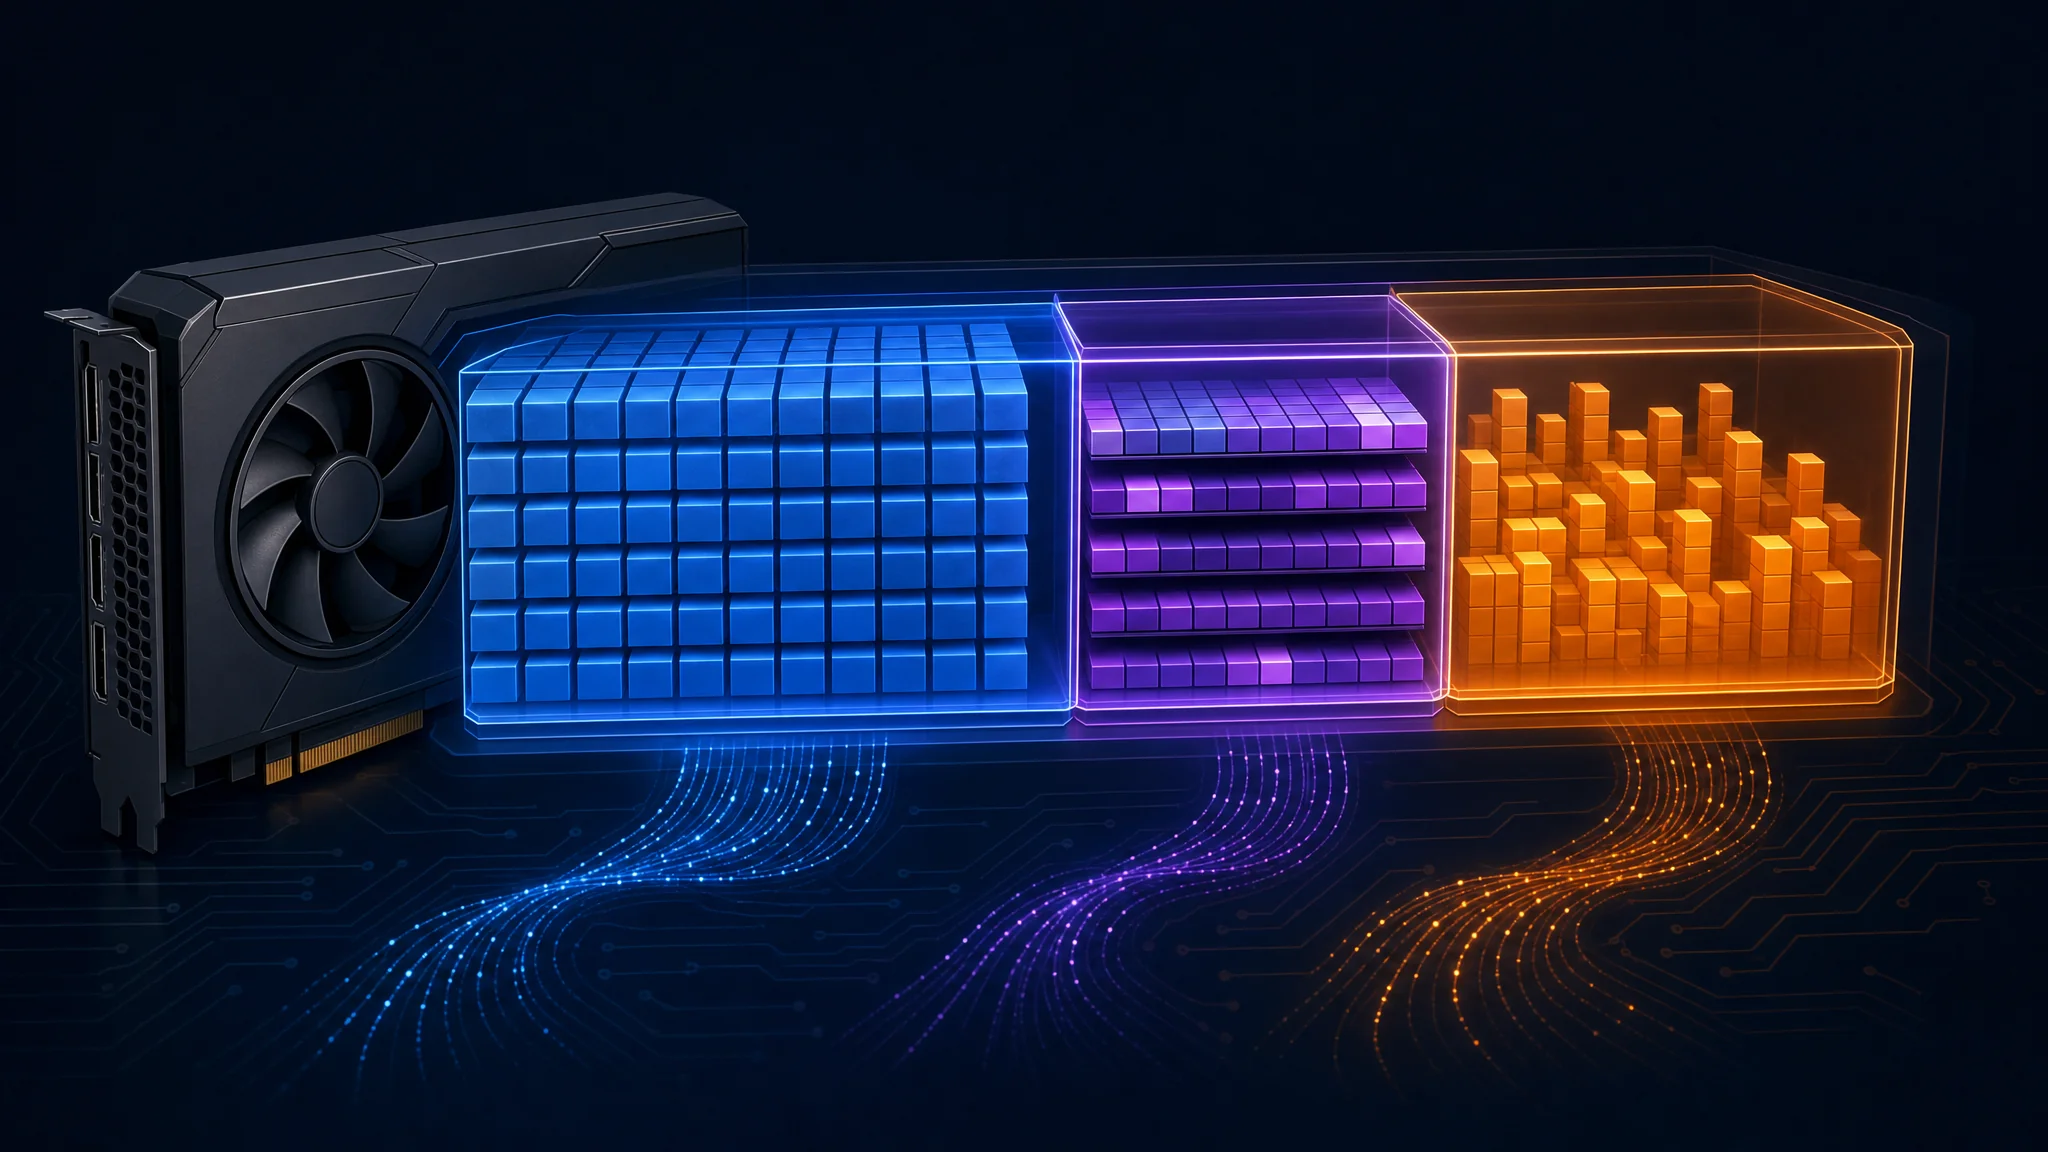
青はウェイト、紫はコンテキストキャッシュ、オレンジはランタイム割り当てを表します。サイズはイメージです
速度が異なる理由
16GB という表示は容量を表します。スループットは、メモリ帯域幅、計算カーネル、アクティブなコンテキスト、オフロード、バッチ処理、投機的デコーディングにも左右されます。
| 原因 | 確認する項目 |
|---|---|
| CPU または RAM へのオフロード | ロード済みレイヤーの配置とキャッシュの場所 |
| 長いコンテキスト | 測定中の使用トークン数 |
| バックエンドの違い | ランタイムのコミット、ドライバー、カーネル経路 |
| 投機的デコーディング | 受け入れたドラフトと追加割り当て |
1 回に 1 トークンを生成する密モデルでは、メモリ帯域幅を常駐ウェイトのバイト数で割ると、帯域幅だけに基づく概算になります。448 GB/s と 11.8 GB のウェイトでは約 38 tokens/s です。キャッシュ読み出しと計算が処理を増やし、投機的デコーディングとバッチ処理が仮定を変えます。
この商を普遍的な上限として扱わないでください。報告された出力速度が高くても、ベンチマークが自動的に無効になるわけではありません。ターゲットモデルの 1 回の処理で複数のドラフトトークンを受け入れたか確認します。
マルチトークン予測、つまり MTP には対応モデルとランタイムが必要です。短いコンテキストと長いコンテキストの両方で、有効と無効の実行を比較します。追加ウェイトとドラフト状態はメモリを消費しますが、32K トークン後に MTP を無効にする普遍的な規則はありません。
最初の応答を測定する
Prefill は生成前にプロンプトを処理します。Decode は回答を生成します。大きな未キャッシュのプロンプトでタスクを開始すると、速い decode 結果でも最初の応答の遅さは隠れます。
未キャッシュのプロンプトトークン数を測定した prefill スループットで割り、プロンプト処理時間を見積もります。新しい 30,000 トークンのプロンプトでは、次の 2 つの例の速度になります。
| 例のプロンプト速度 | 計算上の処理時間 |
|---|---|
| 750 tokens/s | 40 秒 |
| 150 tokens/s | 200 秒 |
これらはモデル読み込みとリクエストのオーバーヘッドを除いた処理時間です。プロンプト長、バッチサイズ、モデル形式、バックエンドが測定速度を左右します。
冷たいリクエストと、再利用可能なプレフィックスを持つ継続処理を別々に測定します。プレフィックスの再利用は、繰り返し入力の一部を再処理せずに済みます。最初のトークンまでの時間を decode 速度とタスク全体の時間とともに記録します。
GPU 構成全体を比較する
購入価格、使用可能なメモリ、帯域幅、ソフトウェア経路をまとめて比較します。安いカードでも、ワークロードが未対応機能を必要としたり、目標レイテンシを超えたりすれば利点を失います。
| 16GB デスクトップカード | メモリ帯域幅 |
|---|---|
| RX 9060 XT | 320 GB/s |
| RTX 5060 Ti | 448 GB/s |
| RX 9070 | 640 GB/s |
| RX 9070 XT | 640 GB/s |
AMD の RX 9070 仕様 と RX 9070 XT 仕様 は、16GB の容量と最大 640 GB/s の帯域幅を確認しています。640 と 448 の比較では理論帯域幅が約 43% 増えます。仕様だけから推論性能が 43% 改善すると判断できません。
使用予定のモデルとバックエンドで測ったベンチマークを選びます。短いプロンプトと持続的な生成では decode 性能を重視します。リポジトリ分析では、コールド prefill、長いコンテキストの速度、タスク完了を優先します。どちらのメーカーを買う前にも、利用可能なソフトウェアを確認します。
Mac とノート PC の表示
16GB の Apple silicon Mac は、CPU、GPU、OS、アプリケーションでメモリを共有します。16GB のディスクリート GPU は、システム RAM とは別に専用ビデオメモリを持ちます。これらの容量は、同じモデル予算を表しません。
Apple は 推奨 GPU ワーキングセットサイズ を公開しています。ランタイムが報告する上限とシステムメモリの圧力を確認します。共有プール全体を推論に割り当てず、macOS と他のアプリケーションのために余裕を残します。
ノート PC では、メーカーの正確な SKU、専用メモリ、GPU 電力制限、冷却を確認します。 NVIDIA の RTX 5060 ファミリーページ は、デスクトップ RTX 5060 Ti のメモリ構成を掲載しています。ファミリー名だけでは 16GB と判断できず、デスクトップ結果からノート PC のスループットも判断できません。
所有は得になるか
回避できるホスティング料金が運用費を上回り、ハードウェア購入額を回収できるとき、所有は経済的に有利です。出力だけの例から始めます。789 ドルのカード、生成中 35 output tokens/s、180W、電気料金 0.18 ドル/kWh、ホストされた出力 100 万トークンあたり 2.95 ドルです。入力値は例です。購入見積もり、実測電力、電気料金、プロバイダー価格に置き換えてください。
Hours per million output tokens = 1,000,000 ÷ 35 ÷ 3,600 = 7.94
Electricity per million = 7.94 × 0.180 kW × $0.18/kWh = $0.257
Savings per million = $2.95 - $0.257 = $2.693
Break-even output = $789 ÷ $2.693 = 293 million tokens
Continuous generation time = 293 × 7.94 ÷ 24 = about 97 days
毎日 8 時間連続で生成すると、同じ計算は約 291 日かかります。アシスタントを開いたままの 8 時間と、トークンを生成する 8 時間は異なります。
ホスト出力が 100 万あたり 0.16 ドルなら、このシナリオではローカルの電気代がすでにホスティングを上回ります。これらの仮定では、出力だけの損益分岐点はありません。
選択したプロバイダーの現在の OpenRouter モデル料金 を使い、入力料金とキャッシュ済み入力料金も含めます。prefill を含むシステム全体の電力を測定します。アップグレード、アイドル電力、保守、予想売却額を加えます。再試行と品質差がタスク単価を変えるため、受け入れられた作業を比較します。
メモリを追加するタイミング
許容できる品質とレイテンシで、測定したワークロードが利用可能なコンテキストを超えたら 16GB を超える容量へ移ります。毎日の長いエージェントセッション、同時リクエスト、高精度ウェイトでは大容量が役立ちます。
16GB カード 2 枚にはランタイムの明示的な対応が必要です。透明な 32GB の割り当てにはなりません。各デバイスにバッファが必要で、通信にはホストのインターコネクトを使います。
| 分割方式 | 主なトレードオフ |
|---|---|
| レイヤー分割 | 異なるレイヤーを異なるデバイスに配置 |
| テンソルまたは行分割 | レイヤー内の処理で通信が増加 |
| CPU と GPU | 異なるレイテンシ特性で容量が増加 |
マザーボード、電源、冷却、バックエンドがすでに計画に対応しているなら、2 枚目のカードを検討します。システム全体のコストを、より大きな単一 GPU と比較してください。 32GB Qwen ハードウェアガイド で選択肢を説明しています。
トラブルシューティングと次の手順
読み込みに失敗したらコンテキストを下げ、割り当てを確認します。セッション中に速度が下がったら、使用中のコンテキストと CPU オフロードを確認します。最初の応答が止まるなら、コールド prefill を測定します。圧縮後にツール利用が壊れたら、高精度モデルで同じタスクを比較します。
通常の指示、ファイル、ツール出力を含む再現可能なテストを 1 つ保存します。モデルリビジョン、ランタイムバージョン、キャッシュ精度、使用中のコンテキスト、ピークメモリ、最初のトークンまでのレイテンシ、decode 速度、タスクの合否を記録します。想定する最長セッションの近くで再実行します。
ローカルモデルとコンテキストのガイド で小さい選択肢を比較します。品質要件を満たす最小のモデルを選び、完全なタスク用に十分なメモリを確保します。この条件では、16GB はワークステーションの実用的な目標です。
Related Posts