

2026年のローカルAI:27BモデルがSonnet 4.6を上回り、ハードウェア購入の好機が終わる
Table of Contents
一般向けのグラフィックカード1枚に収まるダウンロード可能なモデルが、総合知能指数で最先端クラスのAPIモデルを上回りました。 Qwen3.8 27Bは2026年8月に公開されたオープンウェイトの画像・言語モデルです。三値形式に再パッケージしたBonsai 2 27Bは、同じ重みを5.53 GiBに圧縮します。この2つは、ローカル推論が趣味の妥協から有料APIの現実的な代替へ変わった節目を示しています。
ハードウェアを買う好機は急速に終わりつつあります。メモリー価格は過去20年で最も高く、グラフィックカードの価格も押し上げています。
この記事では、ベンチマークの結果、2つのモデルの仕組み、オープンモデルがまだ劣る点、そして今後12か月は待つべきでない理由を説明します。
**この記事を読んだ後にできること:**作業内容に合うモデルとメモリー容量を選べます。購入前に、ハードウェア費用、電力費、コンテキスト長、実測スループットを比較してください。ベンチマーク比較から、あなたのタスクの品質や将来のGPU価格を予測することはできません。
先に結論
ローカルの27Bモデルと、最先端に近い有料APIとの知能差はなくなりました。有料モデルに残る利点は、価格差から想像するほど大きくありません。
同時に3つの変化が起きました。
- **オープンな27Bモデルが最先端に迫るスコアを出しました。**同じ評価セットで、Qwen3.8 27BはIntelligence Indexで33.7、Sonnet 4.6は30.1です。
- 三値量子化によって必要なメモリーが約3分の1になりました。Bonsai 2 27Bは完全な27Bモデルを5.53 GiBで実行できます。数百ドルのカードにも収まる容量です。
- **メモリーの供給は悪化しました。2026年初頭、一般的なDRAMの契約価格は四半期比で90~95%**上昇しました。TrendForceの記録で最大の四半期上昇となり、次世代GPUの発売も2028年にずれ込みました。
今買う、または組み立てる方が安く済みます。販売文句ではなく、供給データから導ける結論です。
GPU 1枚での実演を見る
上の主張は表だけでなく、実演で確かめる価値があります。Bijan BowenはGPU 1枚のシステムでBonsai 2 27Bをテストし、現時点で単体カード向けの最良モデルかどうかを調べました。
トークン毎秒の数値より、出力の品質に注目してください。速度は最も改善しやすい項目です。
2つの名前、同じモデル
ここで取り上げる2つのモデルは競合製品ではありません。同じ重みを異なる精度で表現したものです。
| Qwen3.8 27B | 三値版Bonsai 2 27B | |
|---|---|---|
| 概要 | Qwenのオリジナルオープンウェイトモデル | Prism MLがQwen3.8-27Bを三値形式に再パッケージ |
| 重みの容量 | 18 GB | 5.53 GiB (PTQ1_0) または 6.70 GiB (PQ2_0) |
| パラメーター数 | 27Bの密モデル | 26.90B、同じアーキテクチャ |
| コンテキスト | 256K | 262,144トークン |
| 画像処理 | 対応、ネイティブ | 対応、CLIPプロジェクターは別パッケージ |
| ツール呼び出し | 対応 | 対応 |
| ライセンス | Apache 2.0 | Apache 2.0 |
| 実行環境 | Ollama、llama.cpp、MLX | Prism MLのllama.cppフォークのみ |
Ollamaのqwen3.8ライブラリページには、27Bモデルの容量が18 GB、コンテキストが256K、画像処理とツール呼び出しに対応し、Apple Silicon向けにMLX版が別途あると記載されています。Ollama上の三値版は、Prism MLのApache-2.0ライセンスのGGUFパックを、チェックサムを維持して再公開したミラーです。
**実用上の問いは、どちらのモデルを選ぶかではありません。**同じ知能を得るために、どれだけのメモリーを使うかです。三値版は約3分の1のメモリーで済み、性能低下もわずかです。
ベンチマーク比較
Artificial Analysisは両モデルを同じテストセットで評価しています。得意分野が異なるため、要約だけでなく各行の結果を確認してください。
| 指標 | Qwen3.8 27B | Claude Sonnet 4.6 | 優位 |
|---|---|---|---|
| Intelligence Index | 33.7 | 30.1 | オープン |
| Coding Index | 68.1 | 63.0 | オープン |
| Agentic Index | 45.8 | 31.8 | オープン |
| GPQA Diamond | 90.5% | 87.5% | オープン |
| Humanity’s Last Exam | 33.9% | 33.6% | オープン |
| AA-LCR(長文脈) | 82.0% | 80.0% | オープン |
| GDPval-AA | 45.4% | 36.0% | オープン |
| CritPt(研究物理) | 5.4% | 3.1% | オープン |
| 非ハルシネーション率 | 69.7% | 51.6% | オープン |
| SciCode | 46.6% | 50.1% | Sonnet |
| AA-Omniscienceの正確度 | 15.6% | 40.9% | Sonnet |
比較可能な11項目のうち9項目でオープンモデルが上回り、すべての総合指標でも優位です。
オープンモデルが上回る領域
見出しとなる結果は3つの総合指数です。**Intelligenceは33.7対30.1、Codingは68.1対63.0、Agenticは45.8対31.8。**エージェント指数の差が最も大きく、単発のプロンプトより自動化された多段階ワークフローを実行する場合に重要です。
パーセンタイルで見ると、Artificial AnalysisではQwen3.8 27Bがエージェント指数で全モデルの86%を上回り、コーディングでは76%を上回ります。Sonnet 4.6はそれぞれ68%、72%です。大学院レベルの科学的推論を測るGPQA Diamondで、オープンモデルは**90.5%**を獲得しました。
Sonnet 4.6がなお上回る領域
逆転する指標が2つあります。どちらも軽視できません。
**AA-Omniscienceは、知識に関する質問へ最初の回答で正しく答えられるかを測ります。Sonnet 4.6は40.9%、Qwenは15.6%です。**事実の信頼性に大きな差があり、プレミアムモデルに課金する最も強い単独の根拠です。
非ハルシネーション率には注意が必要です。Qwenの69.7%はSonnetの51.6%を大きく上回り、単独で見ると明確な勝利です。ただし、この指標は不正解の回答のうち、情報を捏造しなかった割合を示しています。正確度の低いモデルは不正解回答が多くなります。そのため2つの割合は異なる回答群を表し、直接比較できません。まず正確度の行を確認してください。
SciCodeでもSonnetは50.1%で、46.6%のQwenを上回ります。また、オープンモデルのカードにないIFBenchとTerminal-Bench Hardの結果も示されています。これらは比較できません。
公平に見るための注意点
**モデルの公開時期には6か月の差があります。**Sonnet 4.6は2026年2月、Qwen3.8 27Bは同年8月に公開されました。2月の最先端モデルと8月のオープンモデルを比べても、同じ条件の競争ではありません。
**Sonnet 4.6はAnthropicの最先端モデルではなくなりました。**現在はSonnet 5とOpus 5が上位にあります。オープンな27Bモデルは2026年半ばの旗艦モデルに追いつきましたが、現行の最上位モデルには追いついていません。表からそれ以上を読み取るのは誤りです。
ベンチマークが測るのはベンチマーク上の性能です。重要なのは、あなたの作業で得られるスコアだけです。
三値重みが変えるもの
Bonsai 2は小型モデルではありません。同じ26.90Bモデルを大幅に低い数値精度で表現しています。公開されたGGUFメタデータに、そのトレードオフが示されています。
| 項目 | 値 |
|---|---|
| アーキテクチャ | qwen35、4層ごとの完全なAttentionとstate-space層を組み合わせたハイブリッド方式 |
| パラメーター数 | 26.90B |
| ブロック数 | 64 |
| 埋め込み幅 | 5120 |
| Attention | Queryヘッド24個、KVヘッド4個、key/value長256 |
| コンテキスト | 262,144トークン、RoPE基数1e7 |
| 重み形式 | 三値、グループサイズ128。PQ2_0は重みあたり2.13 bit、PTQ1_0は1.75 |
| ビジョンタワー | CLIP、460.73Mパラメーター、独立したプロジェクターパックとして提供 |
| ライセンス | Apache 2.0 |
**三値重みでは、各パラメーターが16個ではなく3個の値のいずれかを取ります。**これが圧縮の要点です。完全な27Bモデルが18 GBではなく5.53 GiBに収まります。
実測スループット
32 GBのRTX 5090でllama-benchを実行。全レイヤーをGPUに配置し、flash attentionを有効化。3回の実行の平均値です。
| パック | 重み | 入力処理 (pp512) | 生成 (tg128) |
|---|---|---|---|
| PQ2_0 | 6.70 GiB | 3802.74 tok/s | 135.41 tok/s |
| PTQ1_0 | 5.53 GiB | 1876.31 tok/s | 131.41 tok/s |
PQ2_0のprefillはPTQ1_0より2.03倍高速ですが、decodeの差は統計的に同等です。そのためPQ2_0が標準の選択肢となり、最後の1.2 GiBが重要なときはPTQ1_0を使えます。llama-serverでコンテキスト65Kを設定した場合、単一のストリーミング要求に対するdecodeは136.5 tok/sを維持しました。
**日常使用で体感するのはdecodeの速さです。**毎秒135トークンは読む速度を大きく上回ります。ホスト型APIも十分速いため、遅延はローカル推論を選ぶ理由ではありません。費用、プライバシー、制御性が理由です。
誰も触れない落とし穴
**標準のOllamaではこのファイルを読み込めません。**三値カーネルはPrism MLのllama.cppフォークにあります。Ollama 0.34.2で確認すると、unsupported tensor "output.weight" size overflowsで失敗します。ランタイムはqwen35アーキテクチャを認識しますが、ライブラリにはpq2_0もptq1_0もなく、Hadamard活性化のランタイムもありません。
時間を無駄にする前に知っておくべき落とし穴がもう1つあります。**この系列のF16パックは安全な代替に見えますが、そうではありません。**テンソルは通常のF16とF32なので、エラーなく解析・読み込みされますが、その後に意味不明なテキストを生成します。重みはprism.hadamard.*メタデータが示す回転基底にあります。ランタイムが対応する回転処理を行わなければ、出力は無意味になります。F16パックは50.1 GiBあるため、32 GBのカードには全層を配置できません。
ダウンロード前にモデルカードを読んでください。コミュニティミラーはサポート対象のビルドではなく、このページにも明記されています。
背後にあるMoEの流れ
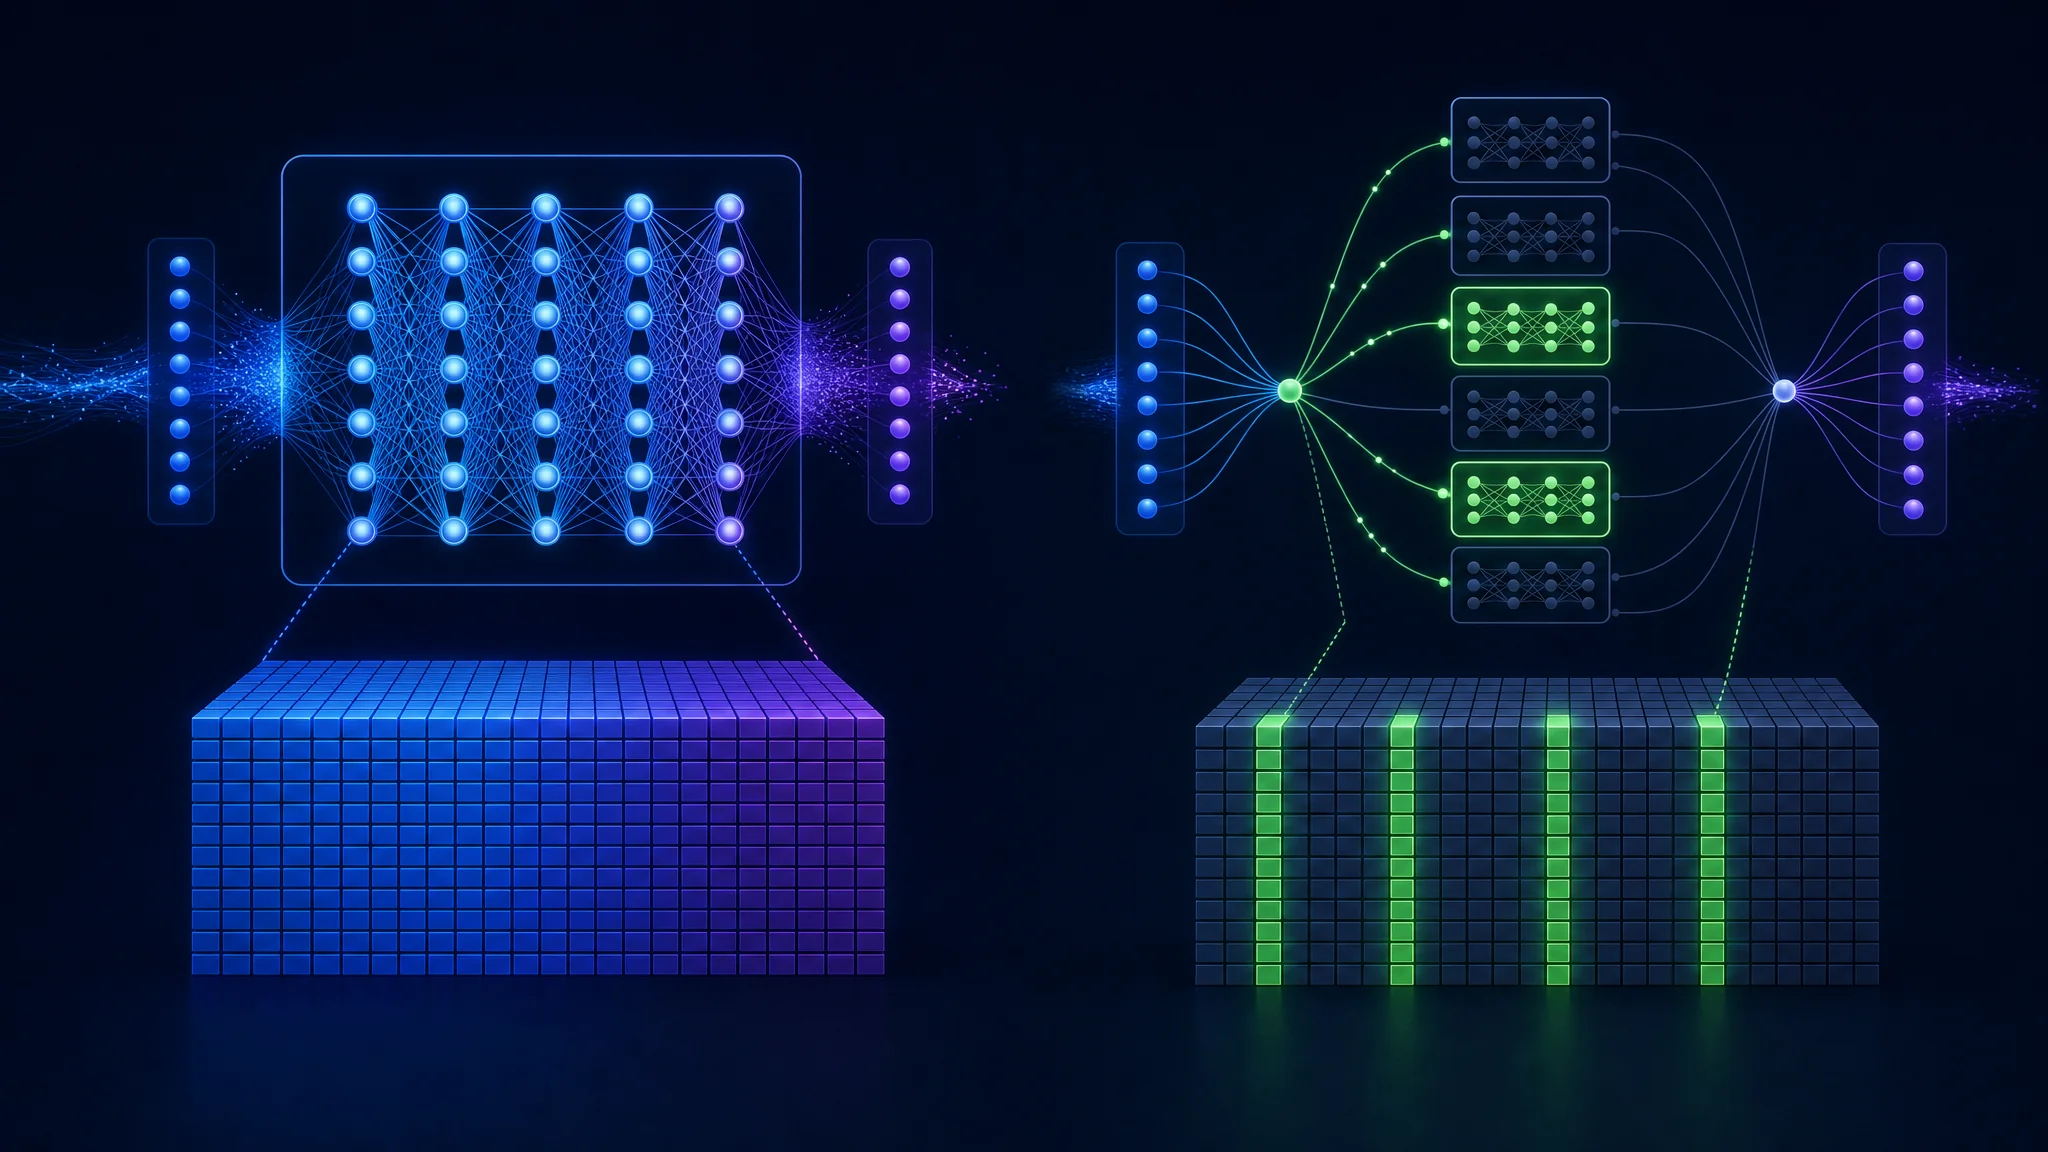
密な27Bモデルは物語の半分です。Mixture-of-Expertsモデルは各トークンでパラメーターの一部だけを有効化するため、費用の構図が変わります。
| モデル | 合計 / 有効 | コンテキスト | 説明 |
|---|---|---|---|
| Qwen3.8 2.4T A95B | 2.4T / 95B | 1.0M | Qwen3.8 Maxと同系統のオープンウェイトモデル |
| Qwen3.6 35B A3B | 35B / 3B | 262K | Apache 2.0、ハイブリッド疎MoE |
| Qwen3 Coder Next | 80B / 3B | 256K | 常時稼働するコーディングエージェント向けのオープンウェイト |
**Qwen3 Coder Nextはローカル用途で注目すべきモデルです。**合計80Bのパラメーターのうち、各トークンで有効になるのは3Bだけです。CLIやIDEで常時稼働するエージェント向けに設計されています。3Bを有効化するモデルは3Bモデルと同じ速度で生成しつつ、80B分の能力を活用します。開発元の説明では、有効な演算量が10~20倍のモデルに匹敵する性能を示しています。
今すぐ使うなら密な27Bが安全な選択肢です。疎モデルの効率はこれからも伸びます。
ハードウェア購入の好機が終わる
この話には期限があります。
ローカル推論が手頃になった時期に、必要なメモリーは高騰し始めました。2つの傾向は衝突へ向かい、その影響はすでに小売価格に表れています。
メモリー価格の変化
**2026年第1四半期、一般的なDRAMの契約価格は前四半期比で90~95%上昇しました。**TrendForceの記録で最大の四半期上昇です。同じ期間にNANDフラッシュも55~60%上昇しました。
圧力は弱まりませんでした。TrendForceによると、第2四半期のDRAMはさらに58~63%、NANDは70~75%上昇しました。第3四半期にDRAMが13~18%、NANDが10~15%の上昇へ減速しても、2四半期連続の記録的な値上がりに積み重なるだけで、値下がりではありません。
原因は景気循環ではなく構造的なものです。AIデータセンターの建設が、以前は携帯電話、ノートPC、ゲーム機向けだったメモリー容量を吸収しています。メモリーメーカーは利益率の高い注文を優先します。モジュール供給を追うアナリストは、2027年にモジュールメーカー向けDRAMチップ供給が70%以上減ると予測しています。
**Intelの最高経営責任者は具体的な数値を示しました。**2026年9月15日、サンタクララのAI Infrastructure SummitでLip-Bu Tanは、メモリー価格が以前の「5倍、6倍、7倍」に達したと話しました。低価格ノートPCの部品原価の70~80%をメモリーだけが占めるとも警告しました。別の発言では、2028年まで改善しないと述べています。
DRAMウェハーと先端ロジックウェハーの面積あたり価格を比較した独立報道には重要な注意点があります。スポット価格は契約価格ではなく、DDR5のスポット市場は薄いため、比較は示唆的でも確定的とは言えません。価格の方向性には疑いがありません。
グラフィックカードへの影響
メモリーはグラフィックカードの部品原価の大きな割合を占めるため、DRAM価格がGPU価格に直結します。
| カード | 2025年初頭 | 2026年9月 |
|---|---|---|
| Nvidia RTX 5090 | $1,999 | $5,000超 |
| Asus RTX 5080 | $1,199 | $1,595 |
| AMD RX 9070 XT | 約$830 | $1,037超 |
値上げは単発ではなく、2026年を通じて連動した波として起きました。Nvidiaは1月に値上げし、5月にはRTX 5090を再度値上げし、年後半にも引き上げました。AMDは8月、選定したRadeonカードとGDDR6メモリーキットを少なくとも10%値上げし、メモリー費用を理由に挙げました。
**次世代製品は発売されず、延期されました。**NvidiaのRTX 60シリーズは2028年の見込みで、2027年は丸ごと飛ばされます。理由としてメモリー供給が挙げられています。
今買うカードは、来年の安いカードと競うのではありません。自分自身の値上がり版と競います。
待つ方が高くつく理由
一般的なハードウェアの助言は、次世代まで待つことです。メモリー供給が制約された市場では、この助言は不利に働きます。
3つの理由があります。
**価格はすでに上昇し、まだ上がっています。**DRAM契約価格が1四半期で90~95%上がるのは、次の四半期に元へ戻る一時的な変動ではありません。TrendForceは第3四半期も値下がりではなく上昇を予測し、Intelの最高経営責任者は改善時期を2028年としています。
**2027年には待つべき新製品がありません。**次世代の一般向けGPUが2028年にずれるなら、待つ期間は2年です。ハードウェア更新サイクルの大半を、何もせず過ごすことになります。
**モデルはすでに実用水準です。**これは2026年に変わりました。2年前は、ローカル環境では明らかに劣る体験しか得られませんでした。今は同じ費用で、コンテキスト262K、毎秒135トークンの27Bモデルを動かし、総合知能指数で有料APIを上回れます。
ローカルモデルが使える水準になるのを待っていたなら、もう待つ必要はありません。ハードウェアの値下がりを待つなら、供給データは2028年を示しています。
構築するシステム
三値重みで必要容量が減ったため、上記モデルに合わせたハードウェア選びは簡単です。
| 段階 | メモリー | 快適に実行できるもの |
|---|---|---|
| 入門 | 8~12 GB VRAM | 5.53~6.70 GiBの三値27Bモデルとコンテキスト用の余裕 |
| 実用 | 16~24 GB VRAM | 18 GBの完全版Qwen3.8 27B、または長いコンテキストを使う三値版 |
| 余裕あり | 32 GB VRAM | コンテキスト262Kの三値27B、または有効パラメーター3BのMoE 80B |
| ユニファイドメモリー | 64~128 GB | Apple Siliconまたは共有メモリー搭載デスクトップで大規模な疎MoEモデル |
段階表より重要な実用上の注意点があります。
- **最上位GPUよりメモリーを買いましょう。**5.53 GiBの三値版なら入門構成も十分使えます。2026年価格の高級カードを追うより、差額をシステムRAMとストレージに使ってください。
- **ユニファイドメモリー搭載機は費用対効果が高い選択肢です。**共有メモリーが64 GB以上のマシンなら、同容量の単体GPUよりずっと安く大規模な疎モデルを実行できます。
- **電力と冷却も重要です。**数時間推論を続けるシステムは、数分のベンチマークを実行するシステムとは挙動が異なります。
- **三値版と小型モデルを併用しましょう。**3Bモデルが簡単な質問に答え、27Bモデルが難しい質問を処理します。
高額モデルにまだ価値がある場面
上位モデルを選ぶ理由はありますが、広告が示すほど広くはありません。
**率直に言えば、事実の信頼性です。**AA-Omniscienceの正確度は、Sonnet 4.6が40.9%、オープン27Bモデルが15.6%です。誤答が顧客、診断、法的立場に損害を与えるなら、25ポイントの正確度差は総合指数より重要です。
**2つ目は長いエージェント処理です。**Sonnet 4.6はTerminal-Bench Hardで53.0%、τ²-Bench Telecomで75.7%です。これらは継続的なツール利用や複数ターンにわたるエージェント動作を測ります。オープンモデルのカードには比較できる数値がありません。この欠落は好材料ではありません。
**3つ目は運用面です。**ホスト型APIなら、ドライバー更新、量子化の癖への対処、llama.cppフォークの追跡、回転基底の重み設定が不要です。稼働時間の管理も深夜3時の呼び出し対応も、別の担当者が行います。
考えるべき問い
企業以外で上位モデルを使う理由は何でしょうか。
**知識が重要な業務には今も価値があります。**調査、法的分析、医療相談、財務モデル、そして自信満々の誤答が高くつくあらゆる作業です。これは現実の用途であり、正確度の差は課金する正当な理由です。
**生成系の作業では、その根拠が急速に薄れます。**下書き、要約、コードのリファクタリング、データの形式変更、文書分類、自動化パイプラインでは、出力を使う前に検証します。人やテストスイートが最初に確認するなら、正確度の差がもたらす損失は小さくなります。すでに持っているハードウェアで33.7の指数が無料で動くのに、30.1の指数へトークンごとに支払うのは説明しにくい選択です。
**選択基準は能力から、失敗時の影響に変わりました。**2年前は、ローカルモデルが作業をこなせるかどうかが問題でした。今は、間違いにいくらかかり、どう検出するかが問題です。
企業向けの追加料金は、信頼性、コンプライアンス、他社のオンコール体制に対するものです。テストスイートが答えを確認すれば意味を失う差に、他の人は料金を払っています。
要点
- ローカル27Bモデルは総合知能指数でClaude Sonnet 4.6を上回り、33.7対30.1です。コーディング、エージェント作業、長文脈、大学院レベルの科学的推論でも優位です。
- **Sonnet 4.6は事実の正確度で優れます。**AA-Omniscienceで40.9%対15.6%となり、上位モデルを選ぶ最も強い理由です。
- **三値量子化が実用化を後押しします。**Bonsai 2 27Bは同じ26.90Bモデルを18 GBではなく5.53 GiBで実行し、どちらもApache 2.0です。
- **標準のOllamaは三値パックを動かせません。**Prism MLのllama.cppフォークが必要で、F16の代替版はエラーではなく、意味不明な出力をひそかに生成します。
- RTX 5090でのdecode実測値は毎秒135トークンで、読む速度を大きく上回ります。
- **今動く理由はメモリー価格です。**2026年にDRAM契約価格が1四半期で90~95%上がり、次世代GPUは2028年に延期されました。
- RTX 5090は2年足らずで$1,999から$5,000超に値上がりし、各価格帯も上昇しました。
次の手順
- モデルをダウンロードし、自分の作業で試す: OllamaのTernary Bonsai 2 27B
- メモリーに余裕があれば、完全精度の元の重みを入手する: OllamaのQwen3.8
- PCを組む前に無料のホスト型エンドポイントで試す: OpenRouterの無料Qwen3.8 27B
- 同じプロンプトで有料モデルと比べる: OpenRouterのClaude Sonnet 4.6
- メモリー表を使って必要な構成を決め、GPUより先にメモリーを買う
- 使っていないRaspberry Piがあるなら、小型モデルを動かせるか確認する: Raspberry Pi 4または5で動くAIモデル
関連記事
| 記事 | 内容 |
|---|---|
| Raspberry Pi 4または5で動くAIモデル | ローカル推論の下限と小型コンピューターで実際にできること |
| Meshtastic向けプライバシー保護AIアシスタントの構築 | プライバシーが必須となるオフグリッド環境のローカルアシスタント |
| データ破損を防ぐECCメモリーの役割 | 大規模モデルを保持するとメモリー品質が重要になる理由 |
| ホームラボとは何か、必要か | 発熱する機器の設置場所、電力、冷却を計画する方法 |
参考資料
- Ternary Bonsai 2 27B - Ollamaモデルミラー
- Qwen3.8 - Ollamaモデルライブラリ
- Qwen3.8 27B(無料) - OpenRouterのベンチマークと価格
- Claude Sonnet 4.6 - OpenRouterのベンチマークと価格
- Bonsai 2 27B初テスト:GPU 1枚で最高のAIモデルなのか? - Bijan Bowen
- Artificial Analysis - 独立したモデル評価
- TrendForce - DRAMおよびNANDの契約価格予測
- メモリーチップの面積単価が演算チップを上回る - Tom’s Hardware
- DRAM価格が95%上昇し、GPU価格の緩和は2028年に延期 - Tech Insider
- IntelのTan氏:メモリー価格は最大7倍、緩和は2028年までなし - shattered.io
- Prism MLのllama.cppフォーク - 三値カーネル
- Ternary-Bonsai-2-27B-gguf - 上流の重み

Related Posts
This article refers to other articles we've written:
- Raspberry Pi 4または5で動くAIモデルは?
Raspberry Pi 4と5の実測値をもとに、メモリ、速度、用途からローカル言語モデルを選びます。小型のLFM2.5から3B以上まで比較します。
- プライバシーを守るMeshtastic向けAIアシスタントの構築
非公開の設定、キュー経由のTCPアクセス、情報取得ツール、安全性を高めたダッシュボードを備えるMeshtastic用ローカルAIアシスタントの構築記録。
