OpenRouterプロバイダールーティング: モデル品質、トークン制限、実際のコスト
Table of Contents
OpenRouterのプロバイダールーティングは、リクエストに応答する推論サービスを決めます。同じモデル名を使う2つの呼び出しでも、エンドポイントの制限、対応パラメーター、サービングソフトウェア、ルーティング設定に左右されます。回答が短くなったりツール呼び出しが失敗したりしたら、量子化を原因と決める前にこれらの違いを確認してください。
要点
- 精度ラベルは数値形式を示すもので、正確さのスコアではありません。
- エンドポイント制限は利用できるコンテキスト、出力長、機能対応を決めます。
- 明示的なルーティングには、プロバイダーの優先順位だけでなくフォールバックポリシーも必要です。
- Auto Exactoは品質シグナルでプロバイダー選択を改善し、ツールを含まないリクエスト向けにオプトインの経路を提供します。
- 実効コストには出力、キャッシュ動作、再試行、タスク完了の成否が含まれます。
前提条件: JSONリクエストの知識と、アプリケーションのOpenRouter設定へのアクセス。エンドポイントの確認には公開APIを使います。モデルリクエストの送信にはAPIキーが必要で、利用料金が発生します。日付付きの例を再現する前にエンドポイントのメタデータを再確認してください。
所要時間と難易度: 初回の設定確認は約20分です。中級者向けです。プロバイダーを有効に比較するには、代表的なプロンプトを使った追加テストが必要です。
モデル名だけでは分からないこと
モデル識別子は要求したモデルを選びます。プロバイダーは、モデル実装、トークン制限、ツール呼び出しパーサーを含む推論サービスを実行します。モデル単位のベンチマークでは、その重みをホストするすべてのサービスを検証できません。
| エンドポイントの項目 | 確認する内容 |
|---|---|
| コンテキスト長 | プロンプト、履歴、ツール結果、生成に使える容量 |
| 最大completion長 | 要求したタスクの出力上限 |
| 対応パラメーター | ツール利用、構造化出力、サンプリング、推論制御 |
| 量子化 | 元のリリースと比較した申告形式 |
| 価格 | 入力、出力、キャッシュ読み取り、適用される追加料金 |
| サービング動作 | completion品質、解析エラー、レイテンシー、再試行 |
基本ルーティングは、正常な候補の中で低価格を優先します。OpenRouterは価格の逆二乗による重み付けを説明しています。単純化した例では、1ドルの候補は3ドルの候補の9倍の選択重みを持ちます。これは相対的な重みであり、次のリクエストを保証するものではありません。明示的な順序、ソート、キャッシュ、品質ルーティングも選択に影響します。 プロバイダールーティングのドキュメント を参照してください。
価格の重み付けから、ワークロードの請求額が最安になるとは言えません。文書の例は、価格計算に使う入力と出力の比率を指定していません。入力価格だけからプロバイダーの選択確率を推測しないでください。
精度を文脈で読む
量子化は数値を小さい表現で保存します。影響はモデル、方式、推論実装に依存します。低い精度にはテストが必要ですが、ラベルだけではプロバイダーが元の重みを変更したとは分かりません。
GPT-OSSには具体例があります。 OpenAIの gpt-oss-120bリリースドキュメント は、Mixture-of-Expertsの重みにMXFP4を使い、評価にも同じ量子化を使ったと説明しています。これらの重みに4ビットというラベルが付くことは公開リリースと整合します。プロバイダーによる追加の品質低下を示す証拠ではありません。
アップキャストは保存値をより広い表現へ変換します。量子化済みチェックポイントをBF16へ変換しても、量子化で失われた情報は戻りません。元は高精度だったチェックポイントを4ビットへ変換する場合は、評価すべき別の変更が発生します。
| 観測 | 支持できる結論 |
|---|---|
| ネイティブMXFP4チェックポイント | 4ビットのエキスパート重みはリリースの一部 |
| BF16エンドポイントラベル | 広い形式の申告であり、より良い回答の証拠ではない |
| 精度不明 | メタデータ不足であり、隠れた劣化の証拠ではない |
| 同じ精度ラベル | 同等のサービング動作を示すには不十分 |
同じラベルでも量子化の違いは排除できません。 どのテンソルを量子化したか、どのキャリブレーションを使ったか、どの実行カーネルを使うかは分かりません。ビット深度を品質順位として扱わず、完全なエンドポイントをテストしてください。
トークン予算を確認する
curl --fail --silent --show-error \
  'https://openrouter.ai/api/v1/models/openai/gpt-oss-120b/endpoints' \
  | jq '.data.endpoints[] | {
      name,
      provider_name,
      context_length,
      max_completion_tokens,
      supported_parameters,
      quantization,
      pricing
    }'
エンドポイントAPIはモデルのプロバイダーメタデータを公開します。このコマンドには**curlとjq**が必要です。サービスを選ぶ前に、
gpt-oss-120bの最新エンドポイント応答
を確認してください。欠落またはnullの項目は無制限ではなく不明として扱います。結果を比較するときは日付付きのローカルスナップショットを保存してください。
2026年10月5日の確認では、gpt-oss-120bについて次の公称制限が返りました。これはメタデータの値であり、測定したcompletion長ではありません。プロバイダーは時間とともに値を変更します。
| プロバイダー | コンテキストトークン | 最大completionトークン |
|---|---|---|
| DigitalOcean | 128,000 | 4,096 |
| Novita | 131,072 | 32,768 |
| Together | 131,072 | 117,964 |
コンテキスト長と出力長は別の制限です。 長いコンテキストに対応するモデルでも、回答用の容量が必要です。会話履歴、システム指示、ツール定義はユーザー文書とともに容量を消費します。
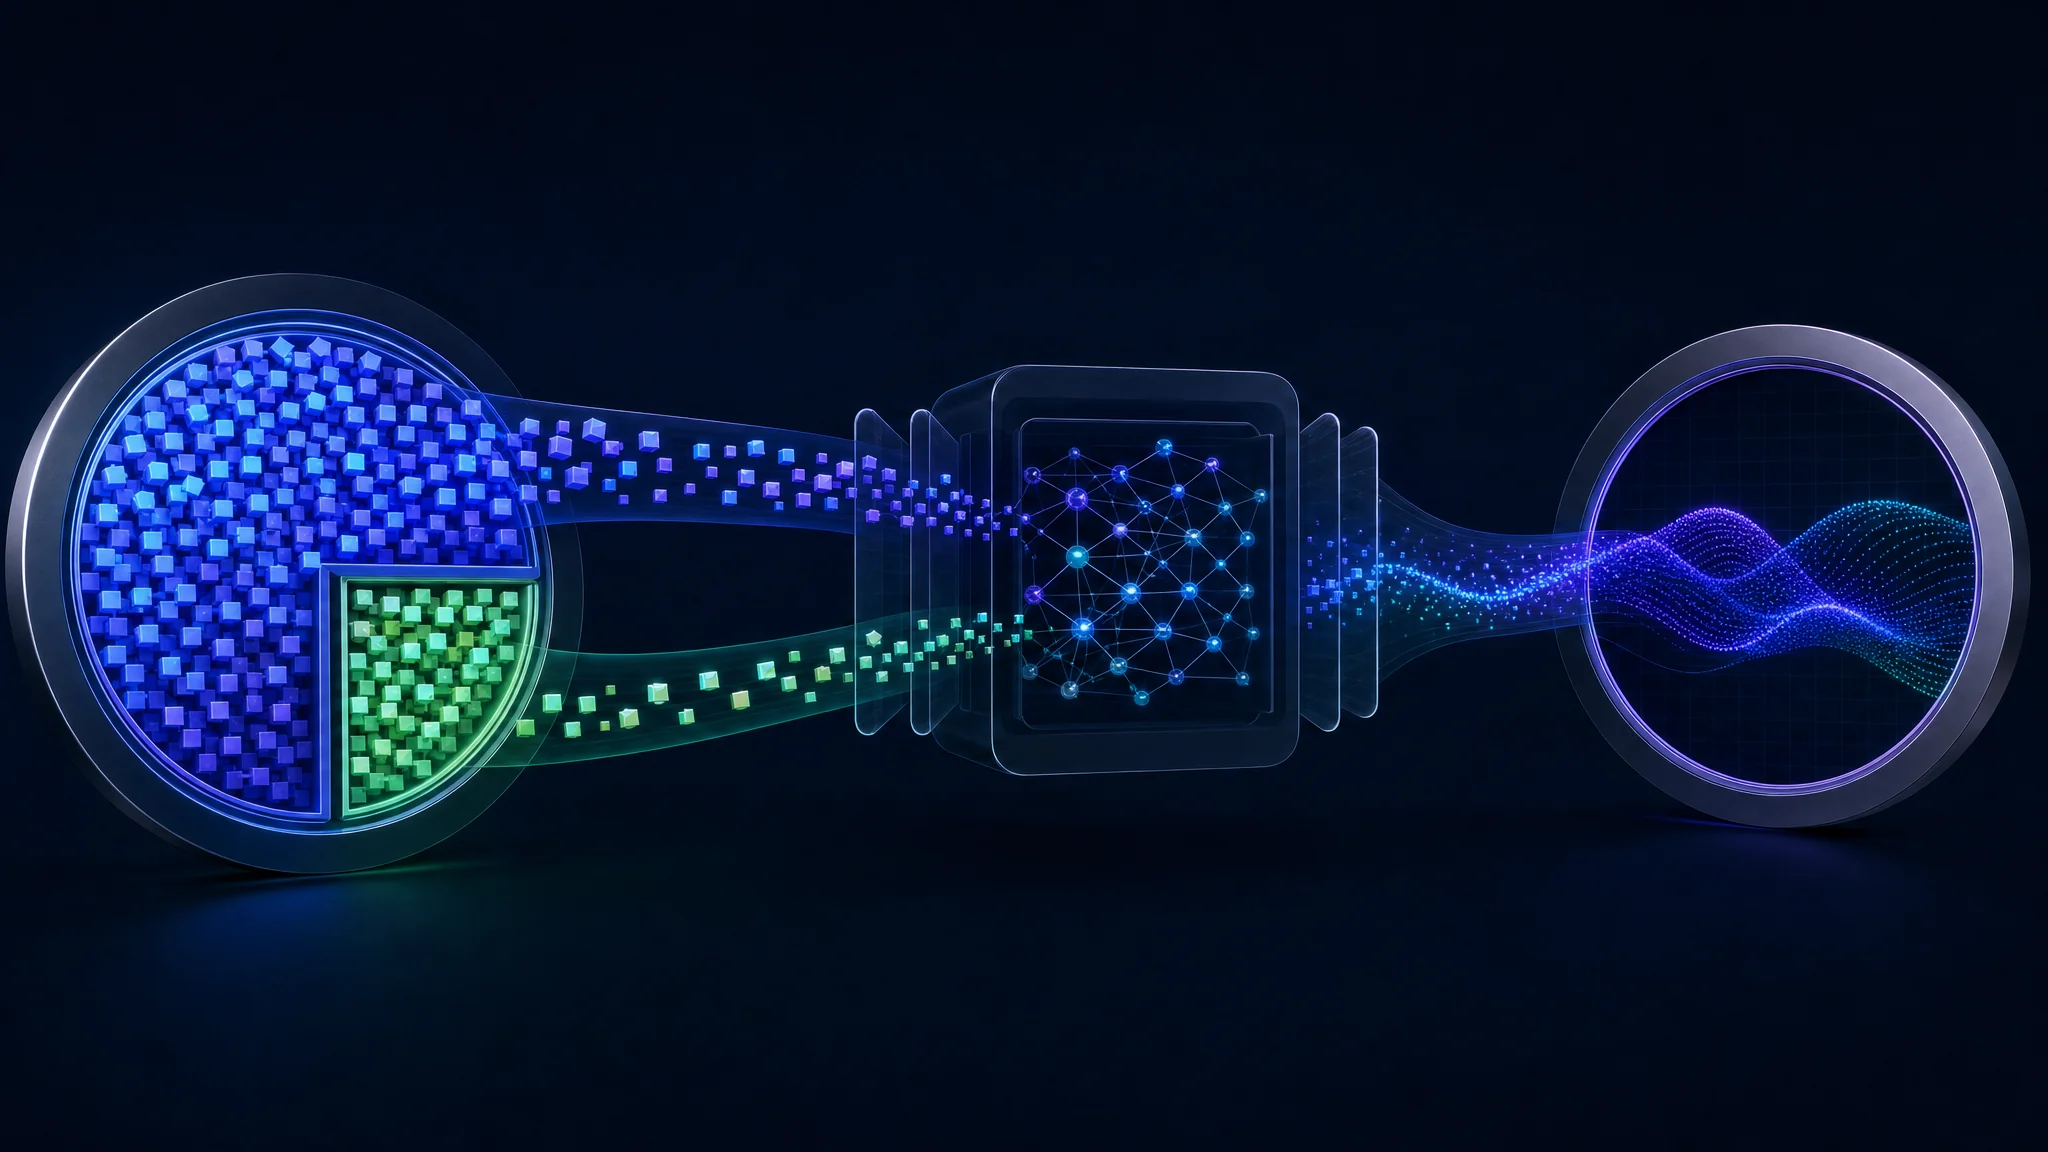
推論トークンは、対応する推論モデルでは生成予算も消費します。小さい予算では推論が未完了になったり、表示される出力が少なくなったり、最終回答前に終了したりします。短い回答を弱い重みの証拠と決めつけず、使用量と終了理由を確認してください。OpenRouterは 推論トークンのドキュメント でこの予算を説明しています。
**明示的なmax_tokens**は、プロバイダー対応と照合する要求出力長をルーターに渡します。測定したタスク要件と利用できるコンテキストから値を選んでください。大きすぎる値は候補を狭め、長く良い回答を保証しません。
対応プロバイダーで、推論と表示出力がcompletion予算を共有する概念的なトークン配分
パラメーターを必須にする
{
  "model": "openai/gpt-oss-120b",
  "messages": [
    {"role": "user", "content": "Explain the failure modes of a retry loop."}
  ],
  "max_tokens": 8192,
  "provider": {
    "require_parameters": true
  }
}
**require_parameters**の初期値はfalseです。初期ルーティングでは、未対応パラメーターがエンドポイントを必ず除外するとは限りません。OpenRouterは、プロバイダーが不明なパラメーターを無視すると説明しています。この値をtrueにすると、申告された対応状況でルーティングを絞り込みます。
対応メタデータは動作を保証しません。 seed対応を申告するエンドポイントにも再現性テストが必要です。ツール対応エンドポイントにもスキーマ検証とアプリケーションテストが必要です。このフィルターは、既知の非互換性が候補集合に入るのを防ぎます。
プロバイダーを意図的に固定する
{
  "model": "openai/gpt-oss-120b",
  "messages": [
    {"role": "user", "content": "Summarize the supplied incident report."}
  ],
  "max_tokens": 8192,
  "provider": {
    "order": ["REPLACE_WITH_VERIFIED_PROVIDER_SLUG"],
    "allow_fallbacks": false,
    "require_parameters": true
  }
}
**プレースホルダーを置き換えます。**モデルのプロバイダー一覧からコピーしたプロバイダースラッグを使ってください。実際のリクエストにはレポートを渡します。このテンプレートは設定確認用です。プレースホルダーを置き換えるまで実行用リクエストではありません。
**orderは優先順位を設定します。これだけでは他のプロバイダーへのフォールバックが有効なままです。allow_fallbacks: false**と組み合わせると、一覧のプロバイダーだけにルーティングを制限します。要求を満たすプロバイダーがないか利用可能なプロバイダーが残っていない場合、リクエストは失敗します。
エンドポイントのバリエーションには注意が必要です。 基本プロバイダースラッグは、文書化された照合規則により複数のバリエーションに一致します。特定のサービス設定をテストするときは、そのバリエーションのスラッグを使ってください。各応答に記録されたプロバイダーを再確認します。
**quantizationsは名前付き形式の許可リストであり、数値の最小値ではありません。"fp8"**を含む配列は対応するFP8エンドポイントを選びます。BF16や、ビット数が多いすべての形式を自動的に含みません。最初に元のチェックポイントを比較し、評価で制限が妥当な場合だけフィルターを使ってください。
品質ルーティングを有効に保つ
{
  "model": "openai/gpt-oss-120b:exacto",
  "messages": [
    {"role": "user", "content": "Compare the two supplied incident reports."}
  ],
  "max_tokens": 8192,
  "provider": {
    "require_parameters": true
  }
}
Auto Exactoはスループット、ツール呼び出しのテレメトリ、ベンチマークを使って、性能の低いプロバイダーの優先度を下げます。OpenRouterの 2026年3月の発表 は、GLM-5のツール呼び出しエラーが88%減り、約8%から約1%になったと報告しています。gpt-oss-120bは5.6%から3.5%になったと報告しています。
これはプロバイダーが報告した展開結果であり、あなたのアプリケーションへの約束ではありません。ツール呼び出しの有効性はJSON、名前、スキーマを測ります。構文が正しい呼び出しでも、タスクに合う引数と動作が必要です。
ツールを含むリクエストは、モデルに十分なプロバイダー対応がある場合、初期状態でAuto Exactoを受けます。それ以外のリクエストでは、**:exacto**が品質ルーティングを選択します。現在のドキュメントは、ツール利用だけでなく要約やチャットにも品質ルーティングを適用しています。
sort: "price"、**:floor**サフィックス、アカウント単位の価格ソート初期値はAuto Exactoを無効にします。アプリケーション設定とアカウント設定を合わせて確認してください。ルーティング制御を組み合わせる前に、
Auto Exactoのドキュメント
を参照します。
ワークロードのコストを計算する
入力価格だけでは比較が不完全です。次の例示料金を使います。単位は100万トークンあたりのドルです。計算方法を示すもので、現在のプロバイダー見積もりではありません。
| 例示エンドポイント | 入力価格 | 出力価格 |
|---|---|---|
| A | $0.03 | $16.00 |
| B | $0.42 | $1.32 |
Workload: 6 million input tokens + 1 million output tokens

A = 6 × $0.03 + 1 × $16.00 = $16.18
B = 6 × $0.42 + 1 × $1.32  =  $3.84

Per million combined input and output tokens:
A = $16.18 / 7 = $2.31
B =  $3.84 / 7 = $0.55
**この組み合わせではエンドポイントAが約4.2倍高くなります。**入力価格が低くても同じです。Aの出力価格と入力価格の533対1という比率は、2つの料金の比率です。利用者の総コスト倍率ではありません。入力と出力の比率を変えると比較も変わります。
**APIの料金単位は比較表と異なります。**エンドポイントAPIはトークン単価で価格を表します。上の料金と比較する前に100万倍してください。
プロンプトキャッシュは別の変数です。キャッシュ読み取り、キャッシュ書き込み、キャッシュなし入力は、プロバイダーの請求規則に従い別々に計算します。繰り返しテキストがキャッシュヒットを保証するわけではありません。 プロンプトキャッシュのドキュメント で、報告されたキャッシュトークン数と費用を確認してください。
ルーティングはキャッシュの継続性に影響します。 OpenRouterはキャッシュ向けのスティッキールーティングを説明していますが、手動のプロバイダー順序が優先されます。Auto Exactoもプロバイダー順序を変え、温まったキャッシュを中断することがあります。どちらかのポリシーを変更する前に、品質と再試行の費用に対する実測キャッシュ節約を比較してください。
受け入れ結果あたりのコストはアプリケーションに有用な指標です。再試行と失敗を含む総支出を、受け入れ条件を満たす結果数で割ります。トークン以外の適用料金は別に含めてください。低いトークン単価でも、失敗するタスクを繰り返せば補えません。
一貫しない回答を診断する
| 症状 | 最初の確認 |
|---|---|
| 短い、または未完了の回答 | 終了理由、出力予算、推論使用量 |
| 文書の詳細が欠落 | 送信内容、エンドポイントのコンテキスト制限、クライアントの切り詰め |
| 不正なツール呼び出し | 申告された対応、ツールスキーマ、解析動作 |
| サンプリング動作の違い | 要求パラメーターと申告された対応 |
| 予想外の費用 | 出力量、キャッシュ読み取り、再試行、プロバイダー変更 |
| 利用できるプロバイダーがない | 競合する制限、許可リスト、フォールバック制限 |
応答と一緒に返る生成IDを保存します。 OpenRouterの 生成メタデータAPI は、プロバイダーID、使用量、費用、終了情報を公開します。セッションIDは関連作業をまとめますが、1つのリクエストを調べる生成IDの代わりにはなりません。
生成IDとともにリクエストを保存します。 モデル、プロバイダー設定、要求パラメーター、時刻、応答使用量を一緒に保存してください。ルーティング、価格、エンドポイントメタデータが変わっても、後の品質やコスト比較を再現できます。
同じ条件でエンドポイントを比較します。 同じプロンプト、ツール、推論設定、トークン予算を使います。複数の代表的なタスクで繰り返します。未完了の回答、無効なツール呼び出し、誤答を、説明のない1つの品質スコアにまとめないでください。
ベンチマークの不確実性は重要です。 Epoch AIの ベンチマーク分析 は、実装、サンプリング、エージェント構成による差を説明しています。1つの期待外れの回答だけでは、プロバイダーの継続的な欠陥や原因は分かりません。
エンドポイントルーティングの手順
関連動画: OpenRouterのエンドポイント品質とルーティングに関する説明 。特定の価格、制限、プロバイダー比較を適用する前に、エンドポイント一覧を再確認してください。
次の手順
- 1つのモデルのエンドポイントを確認し、ワークロードに必要な制限を記録します。
- ルーティングポリシーを選び、パラメーター要件とフォールバック動作を明示します。
- 代表的なタスクをテストし、候補エンドポイントと品質ルーティングを比較します。
- 受け入れ結果あたりのコストを記録し、レイテンシー、キャッシュ使用量、失敗分類も残します。
- モデルバージョン、サービス動作、プロバイダー価格を変更した後に再確認します。
AIの基礎を広く学ぶには、 AIの基本概念 へ進んでください。エージェントの権限と検証制御については、 AIシステムの保護 を読んでください。
Related Posts