16GB GPUでのローカルAIコーディング: Strata、OpenCode、Qwen3.8
Table of Contents
16GB GPU上のローカルコーディングエージェントは、範囲を限定した開発作業に実用的です。 StrataとOpenCodeは、ローカル推論、ファイル編集、シェルコマンド、テスト実行を組み合わせます。RTX 4060 Tiで報告されたQwen3.8-Flash-Nextの実行は、有料推論呼び出しなしでアプリケーション、追加変更、レーシングゲームのプロトタイプを完成させました。
サブスクリプションの置き換えには、より広いテストが必要です。 公開結果は1台のマシンで動く構成を示します。複数の言語、リポジトリ、難しいデバッグ作業で有料コーディングサービスと同等とは証明していません。ハードウェアには64GBのシステムRAMもあり、モデルの大部分を支えています。
要点
- 16GBはGPUメモリを指します。報告された構成に必要な総メモリではありません。
- プロンプト再利用は重要です。コーディングエージェントは重複する会話履歴を繰り返し送るからです。
- 推論には予算が必要です。計画、コード、ツール呼び出しに余地を残します。
- 生成テストの成功は部分的な証拠です。Dockerとゲームプレイには別の確認が必要です。
- API費用ゼロには所有コストが含まれません。電力と保守時間も別に考えます。
前提条件: 対応するコンピューター、選択したモデル用の十分な空き容量、Git、npmを含むNode.js、ターミナルツールの知識。報告されたIQ3_S構成には64GB RAMを合わせます。他の構成は現在のStrataインストーラーで確認します。
時間と難易度: 中級。作業完了速度を評価する前に、大きなモデルのダウンロードとインストールに時間を割きます。報告された作業時間にセットアップは含まれません。
テスト構成
| コンポーネント | 報告された構成 |
|---|---|
| GPU | NVIDIA RTX 4060 Ti、16GB VRAM |
| CPU | Intel Core i5-11600K |
| システムメモリ | 64GB RAM |
| ストレージ | NVMe SSD |
| モデル | Qwen3.8-Flash-Next、125B MoE、IQ3_S |
| 推論エンジン | Strata |
| コーディングエージェント | OpenCode |
| 設定コンテキスト | 65,536トークン |
| 設定出力上限 | 16,384トークン |
NetworkCoderが公開した構成と結果がこれらの数値を示します。 テストリポジトリ は、46.84GiBのエキスパート重みを28秒で読み込み、4,431個のエキスパートがGPUメモリ8.45GiBを使用したと報告しています。これらはテスト実行の測定値であり、別のエンジンバージョンで同じ割り当てになる保証ではありません。
現在の互換性はこのテストより広い範囲にあります。 2026年10月6日時点で、 Strataプロジェクト は12GB以上のVRAMを持つ一部のNVIDIAおよびAMDカードと、32GB RAMシステム向けの小型モデルを記載しています。これらは16GB GPU、64GB RAM、IQ3_Sの実験を再現しません。ハードウェアを購入する前に、GPU、モデルの種類、ランタイム対応を確認します。
モデルの配置
Mixture of experts、略してMoEは、各トークンでモデルのエキスパートネットワークの一部を有効にします。全パラメーターを毎回使うより、アクティブな計算量を減らします。残りの重みには保存領域と計算経路が必要です。
Strataのハイブリッド実行は、頻繁に使うエキスパートをGPUに置き、エキスパート全体をシステムRAMに保持します。CPUはキャッシュされていないエキスパートを処理し、GPUはキャッシュ済みエキスパートを処理します。ストレージにはモデルファイルと検索データもあります。システムは125Bモデル全体を16GB VRAMに収めません。
GPUメモリには競合する用途があります。 ランタイム割り当て、アテンション状態、エキスパートキャッシュが限られた資源を共有します。コンテキストに多くの領域を割くと、残りのエキスパートキャッシュ容量が変わります。現在のStrataはKVキャッシュストリーミングにも対応するため、正確な配置は古い構成と異なります。エンジンのバージョンに対応する 技術文書 を確認します。
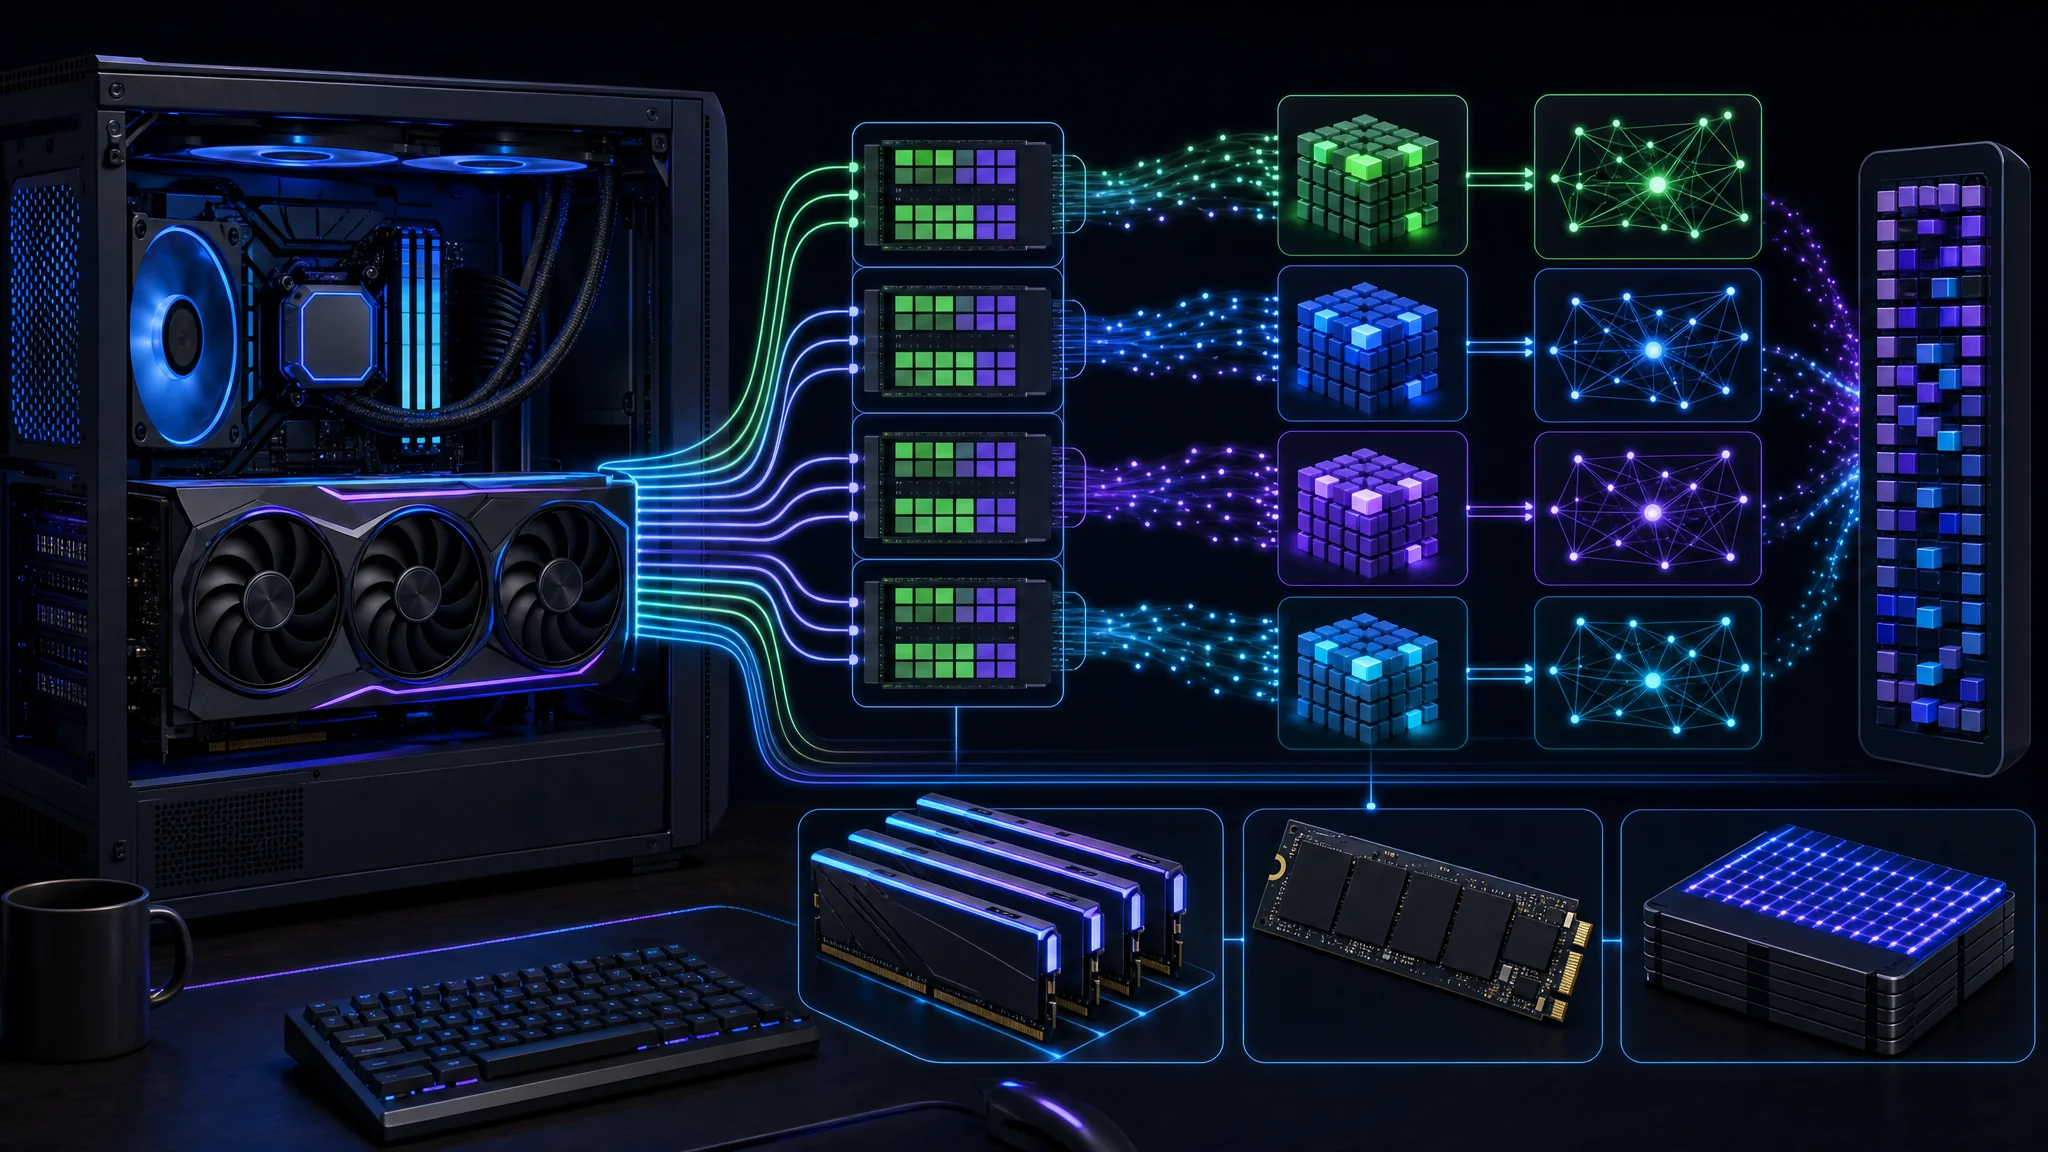
The GPU is one part of the inference system, alongside CPU execution, system RAM, and storage
プロンプト再利用が速度を変える
コーディングエージェントはループで動きます。 タスクを読み、ツール操作を求め、結果を受け取り、次の操作を決めます。ファイル内容、エラー、テスト出力が会話に蓄積します。エージェントはコンテキストを圧縮または選択するため、すべての実装が変更されていない完全な履歴を永遠に再送するわけではありません。
Prefillは生成前に入力トークンを処理します。Decodeは応答を生成します。decodeが速くても、繰り返すprefillが遅いシステムでは、ツール呼び出しの間に待ち時間が残ります。
報告された44Kトークンの測定ではプレフィックス再利用を使いました。 Strataは処理済みの会話内容を再利用し、増加したプロンプトを約1から3秒で準備しました。継続中のエージェントセッションには有用な証拠です。44,000個の完全に新しいトークンを1秒で最初から処理した証拠ではありません。
| 測定 | 記録する内容 |
|---|---|
| コールドプロンプト | 再利用可能なプレフィックス状態なしで新しい内容を処理する時間 |
| ウォーム継続 | 既存コンテキストにツール結果を追加した後の時間 |
| 生成速度 | 応答中の1秒あたりトークン数 |
| 作業時間 | 計画、生成、ツール、テスト、再試行の合計 |
2つのキャッシュは目的が異なります。 エキスパートキャッシュは頻繁に使う重みをGPU計算の近くに置きます。プレフィックス再利用は以前の入力の再処理を避けます。エキスパートキャッシュの高いヒット率は、プロンプトキャッシュのヒットを証明しません。
タスクで確認できたこと
| タスク | 報告時間 | 報告結果 |
|---|---|---|
| タスク管理アプリを作成 | 3m 38s | Express API、インターフェース、5/5テスト |
| 編集を修正して日付を追加 | 4m 58s | 変更完了、6/6テスト |
| エクスポート、インポート、パッケージ化を追加 | 3m 48s | 7/7テスト、Dockerビルド未検証 |
| レーシングゲーム、初回 | 6m 35s | 推論中に出力を使い切り、コードなし |
| レーシングゲーム、予算付き再試行 | 4m 51s | ゲーム生成、JavaScript構文を確認 |
** 公開された結果ファイル **は、最初のタスクで毎秒48から52トークン、2番目で40から43、3番目で37から44を記録します。「最大52」は観測内のピークであり、すべてのタスクの持続速度ではありません。
最初の3タスクは1つのアプリケーションを拡張します。 5/5、6/6、7/7は連続するテストスイートです。合計しても18個の独立した能力は証明されません。同じエージェントが書いたテストにも、カバレッジとアサーションの確認が必要です。
環境の復旧も作業の一部でした。 エージェントは不適切なシェルコマンドから復旧し、テスト中に古いアプリケーションサーバーを特定しました。これは有用な動作ですが、共有開発環境で既存プロセスを終了するには明確な権限が必要です。
Dockerは未検証のままです。 エージェントはDockerfileを書きましたが、ビルド用の稼働中Dockerエンジンがありませんでした。コンテナ外でアプリケーションテストが通っても、動作するイメージの証明にはなりません。ゲームの再試行では構文を確認してブラウザーを開きましたが、ゲームプレイの直接的な視覚確認はありませんでした。
出力用の領域を確保する
{
  "reasoning_budget_tokens": 8000
}
この設定を既存のstrata-iq3_s.json構成に統合します。 他のフィールドを保持して、選択したStrataモデルを再起動します。これはStrataの設定であり、OpenCode設定ファイルの置き換えではありません。起動出力で有効な予算を確認します。
Strataはハードな推論予算を記載しています。 これは思考段階を終了して回答へ移行します。リクエスト単位の値は設定済みの既定値を上書きします。lowやhighのような一般的な推論努力の指示とは異なります。
初回のゲーム試行は計画中に16,384トークンの上限を使い切りました。 再試行では8,000トークンの思考予算を適用し、コードを提供しました。これはこのワークロードで上限付き推論段階を使う根拠です。すべてのタスクで8,000が最適だとは示しません。
残りの出力上限は最大値であり、予約保証ではありません。 16,384トークンの総上限で8,000トークンを完全に使うと、他のオーバーヘッドの前に約8,384トークンが残ります。結果ログは再試行で11,054トークンを書いたと記録しますが、推論とコードの完全な内訳はありません。同じ上限内で8,000推論トークンと11,054コードトークンと解釈しないでください。
狭い修正には小さな予算を使います。 より多くの分析が必要なタスクでは大きな予算を試します。完全なファイル出力、終了状態、テスト結果を確認します。計画時間を増やす価値は、提供された変更が改善するときだけあります。
StrataとOpenCodeを接続する
git clone https://github.com/Niko1221/Strata.git
cd Strata
./setup.sh
これはLinuxのセットアップ入口です。 現在のインストール手順を確認し、Windowsでは文書化された START-HERE.bat を使います。報告された構成に近づけるため、元のQwen3.8-Flash-Next IQ3_Sと65,536トークンのコンテキストを選びます。エンジンのバージョンとモデルファイルをベンチマークメモに保存します。
npm install -g opencode-ai
OpenCodeは
公式手順
でインストールします。 別のターミナルで、Strataが表示するローカルAPIベースを STRATA_BASE_URL に設定し、/v1 サフィックスを含めます。この構成では推論をローカルマシンに限定します。
{
  "provider": {
    "strata": {
      "npm": "@ai-sdk/openai-compatible",
      "name": "Strata local",
      "options": {
        "baseURL": "{env:STRATA_BASE_URL}",
        "apiKey": "local"
      },
      "models": {
        "qwen3.8-flash-next-iq3_s": {
          "name": "Qwen3.8-Flash-Next IQ3_S",
          "limit": { "context": 65536, "output": 16384 }
        }
      }
    }
  },
  "model": "strata/qwen3.8-flash-next-iq3_s"
}
providerブロックを~/.config/opencode/opencode.jsonに統合します。 既存の設定を保持します。これは
公開された設定例
を、環境変数からローカルエンドポイントを読み込む形にしたものです。OpenCodeは
カスタムプロバイダー
と
環境変数置換
を文書化しています。
localはプレースホルダーの認証情報です。 認証なしのローカル構成例に合わせています。サーバーを保護するものではありません。Strataで認証を有効にした場合は、適切なローカル秘密情報の仕組みで設定済みの認証情報を渡します。
使い捨てのプロジェクトコピーでopencodeを起動し、設定済みのモデルを選びます。 コードを送る前に選択されたプロバイダーを確認します。クライアント側のコンテキスト宣言はサーバーの設定コンテキストを増やしません。出力にも領域が必要なため、65,536トークンのウィンドウ全体を入力に使えるわけでもありません。
ローカル推論と権限
{
  "permission": {
    "edit": "ask",
    "bash": "ask"
  }
}
エージェントを評価する間、この初期権限をOpenCode設定に統合します。 権限ドキュメント で使用できる制御を確認します。推論場所に関係なく、ファイル変更とシェル実行はマシンに影響します。
ローカル推論ですべてのツールがローカルになるわけではありません。 パッケージのダウンロード、Webツール、外部連携、任意の共有にはネットワークサービスが関係します。プライベートリポジトリを扱う前に有効なツールを確認します。「モデルがローカルで動く」は「何もコンピューターの外に出ない」より狭い主張です。
初回実行のトラブルシューティング
| 症状 | 最初に確認すること |
|---|---|
| プロバイダーが利用できない | Strataが実行中で、環境変数がOpenCodeプロセスに届いている |
| モデルが選択肢にない | プロバイダーIDとモデルIDが保存済み設定と一致している |
| コンテキスト上限エラー | プロンプト長と要求出力がサーバーの有効なウィンドウに収まる |
| コードなしの計画 | 推論予算、総出力上限、終了状態 |
| 継続が遅い | プレフィックス再利用、メモリ圧力、エキスパートキャッシュの動作、競合プロセス |
| Dockerコマンドが失敗 | CLIだけでなく、動作するエンジンがある |
一度に1つの設定だけ変更します。 保存した開始状態から同じタスクを繰り返します。設定改善を別のプロンプトや簡単なテストから切り分けられます。
サブスクリプションを置き換えるか
| ローカル構成を試す価値がある場合 | 別の選択肢を残す場合 |
|---|---|
| 対応ハードウェアが手元にある | 未検証のワークロードだけを理由にハードウェアを購入する |
| 範囲を限定したアプリ変更 | 大きく未知のリポジトリと難しい移行 |
| 再現可能な受け入れテスト | 正しさを確認する確かな方法がないタスク |
| ランタイム保守の時間がある | セットアップとサポートの負担を抑えたい作業 |
API費用ゼロには意味があります。 すでにハードウェアがある場合は特に有効です。電力、ハードウェアの減価、ストレージ、環境保守の時間は含みません。表示されたゼロコスト欄もこれらを計測しません。
サブスクリプション比較には同じタスクが必要です。 両方のシステムで同じ開始リポジトリ、指示、受け入れ確認を使います。再試行と人間の修正を経過時間とともに記録します。成功した再試行だけでなく、全体の流れの評価に失敗した初回ゲーム試行も含めます。
有用なローカルエージェントに万能性は必要ありません。 日常的な修正を安定して処理し、難しいタスクの一部を別のツールに残せば、必要な有料サービスは変わります。自分のプロジェクトで受け入れた成果を基準に決めます。
デモと次の手順
関連動画: 125Bローカルコーディングエージェントのデモ 。上記の測定値は公開テストのものであり、この記事用に実施した独立ベンチマークではありません。
- 小さなタスクを1つ再現します。 固定した受け入れ基準と保存済みの開始リビジョンを使います。
- コールドとウォームのターンを測定します。 プレフィックス再利用をコールドprefill速度として扱いません。
- パッケージ化を別に確認します。 イメージのビルド成功、起動、コンテナ内チェックを行います。
- 生成されたテストを確認します。 実装が想定していないケースを追加します。
- 完成した作業を比較します。 サブスクリプションを変更する前に現在のコーディングツールと比べます。
ハードウェア計画については、 ローカルAIモデルとGPUコンテキストガイド を読みます。ホストモデルの動作については、 OpenRouterのプロバイダールーティングとコスト を確認します。
Related Posts