モデルウェイト、KV キャッシュ、プロンプト処理を基準に 16GB のローカル LLM 構成を見積もります。Qwen3.8 27B のメモリ予算、GPU 帯域幅、所有コストを比較します。
 イラストであり、ベンチマーク出力ではありません#Qwen3.8 27B
#量子化
#コンテキストウィンドウ
#llama.cpp
#コーディングエージェント
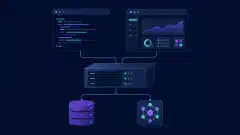
OpenCode のターミナルクライアントとデスクトップクライアントを、サーバーアーキテクチャ、プロバイダー設定、スクリプト、セッション状態、トラブルシューティングの観点で比較します。
 #コーディングエージェント
#エージェント権限
モデル選択、ローカル推論、料金、権限、プロジェクト指示、日々のコーディング作業について OpenCode と Claude Code を比較します。
 #コーディングエージェント
#Ollama
#エージェント権限
#コードレビュー
ベンチマークスコア、メモリ見積もり、サービング速度、エージェント検証を使い、ローカルAIとChatGPTおよびClaudeを比較します。RTX 5090、DGX Spark、Mac Studioの構成も扱います。
 ローカルAIとホスト型AIの概念図。#ローカルLLM
#Qwen3.8 27B
#量子化
#VRAM
#ローカル推論
コーディングエージェント向けのローカルAIモデル選びを解説する、2026年10月の実践ガイドです。GPUメモリ、KVキャッシュの増加、コンテキスト長、量子化品質、プロンプト処理、推論設定、クラウドレンタル費用を比較します。
 #コーディングエージェント
#VRAM
#コンテキストウィンドウ
#量子化
#llama.cpp
コンテキストマニフェストを取得し、エージェントポリシーを読み込み、信頼できるベースとの GitHub Actions チェックで保持期間の提案を検証します。
 #コーディングエージェント