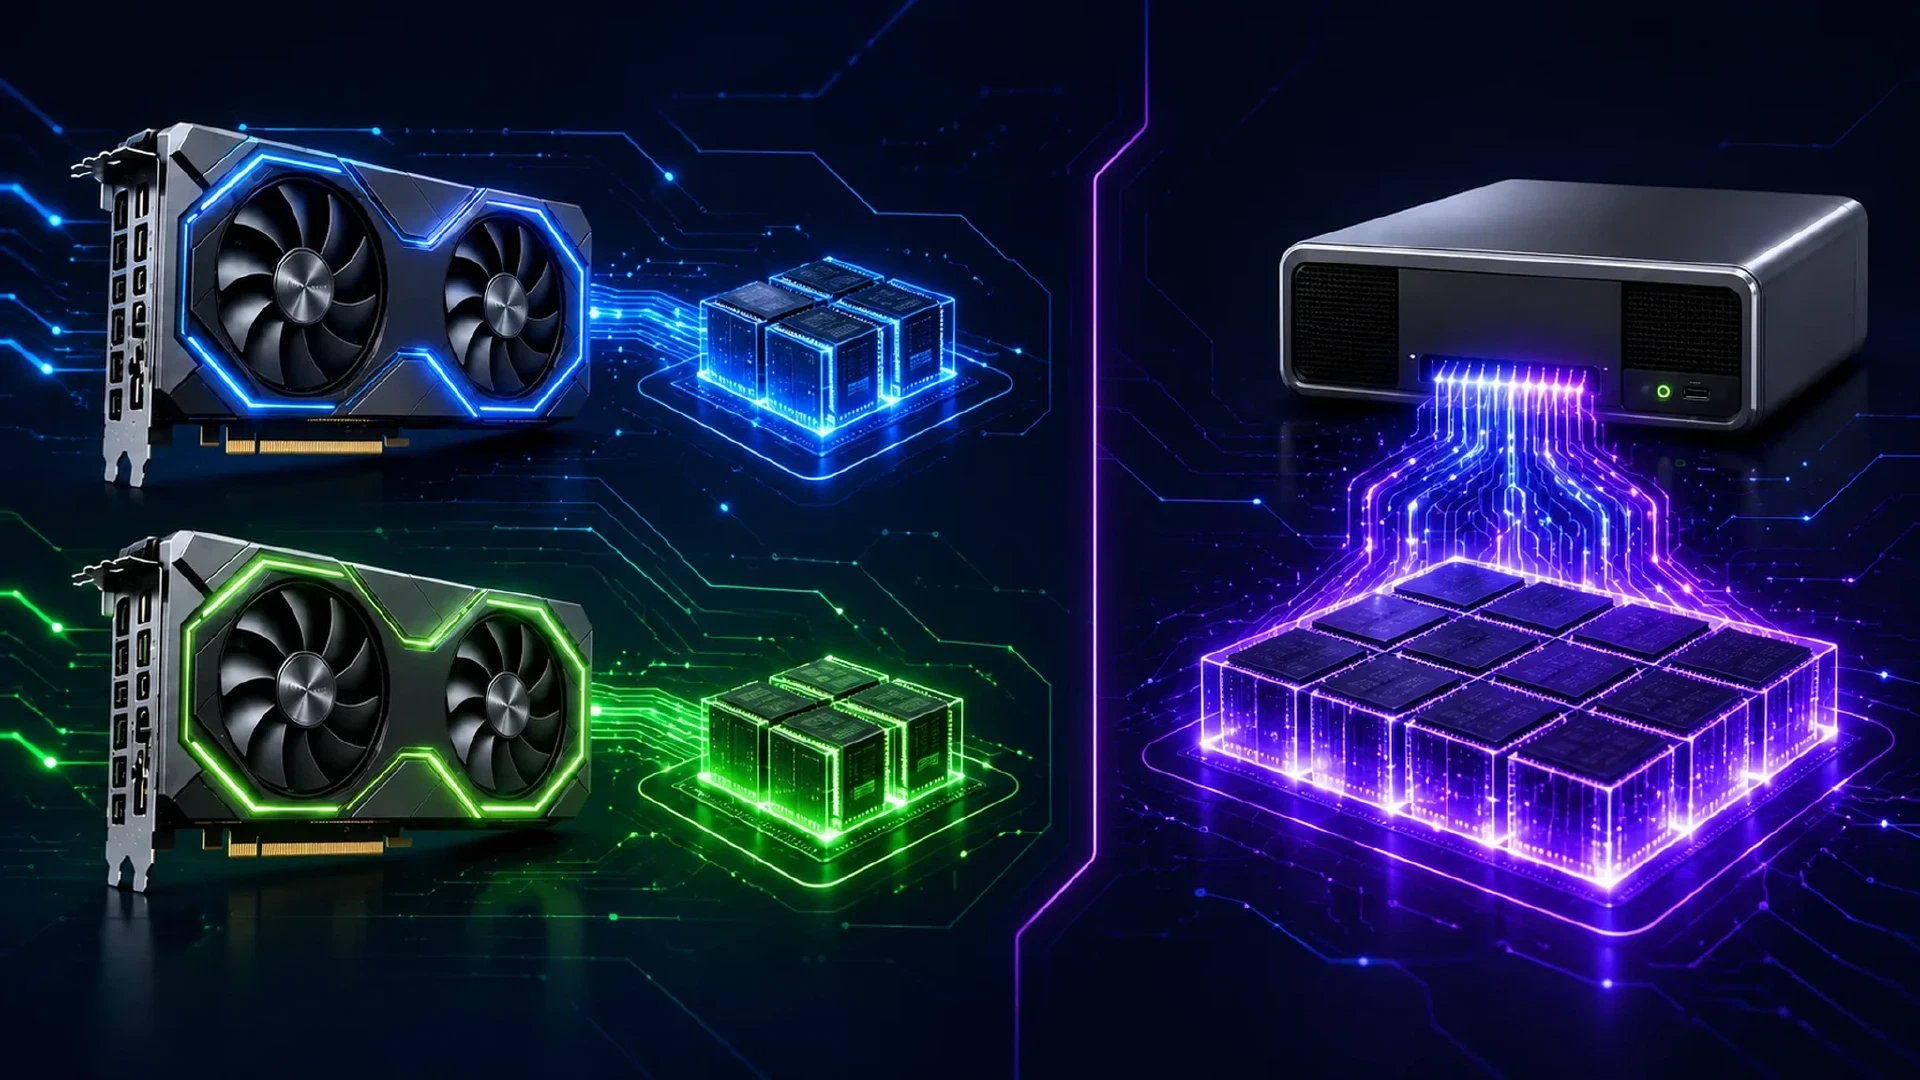
Qwen 3 27B と長いコンテキストのローカル推論を対象に、16 GB の RTX 5060 Ti 2 枚と NVIDIA GB10 システムをベンチマークで比較します。
 ローカルモデルの性能はGPUの枚数だけでなく、メモリアーキテクチャで決まります。#ローカルLLM
#ローカル推論
#VRAM
ローカル推論かホスト型AIサービスかを選ぶ前に、プロンプト、モデルファイル、ツール、ログ、ネットワーク公開範囲、電力コストを確認します。
 ローカルAIとホスト型AIのデータ経路の図#ローカル推論
#llama.cpp
StrataとOpenCodeでローカルコーディングエージェントを実行します。報告されたRTX 4060 Tiの結果、RAM要件、プロンプト再利用、推論予算、有料サブスクリプション置き換えの限界を確認します。
 #ローカル推論
#コンテキストウィンドウ
ベンチマークスコア、メモリ見積もり、サービング速度、エージェント検証を使い、ローカルAIとChatGPTおよびClaudeを比較します。RTX 5090、DGX Spark、Mac Studioの構成も扱います。
ローカルAIとホスト型AIの概念図。#ローカルLLM
#Qwen3.8 27B
#量子化
#VRAM
#ローカル推論