回答の完了率、維持された能力、コンテキストの使用量、量子化、必要なVRAMを基準にローカルモデルの派生版を比較します。
 #ローカルLLM
#vram
#量子化
#ollama
#qwen3.8
ネットワーク全体のDNSフィルタリングからローカルAIまで、10段階でホームラボを構築します。各段階のハードウェア、費用、スキル、トレードオフを説明します。
 #ホームラボ
#Docker
#Tailscale
#ollama
#ローカルai
RTX 5060 Ti、RTX 2000E Ada、RTX 3060 Ti、RTX 3070での長いコンテキスト、ツール、ストリーミング、画像認識の検証に基づくHermes向けモデルの推奨です。
 #RTX 5060 Ti
#llama.cpp
#ollama
#qwen3.8
Hermes、LiteLLM、Tailscale Aperture、Pearlマイニングを使った、検証済みのオンデマンド型ローカルAIフリートとT0〜T4の制御プレーンを紹介します。
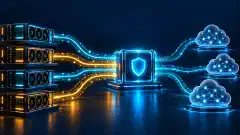 階層型エージェントフリートが各タスクを適切なモデルへ送り、アイドル状態のGPUはマイニングに戻ります#Tailscale
#llama.cpp
#ollama
#ローカルLLM
#セルフホストAI
モデル選択、ローカル推論、料金、権限、プロジェクト指示、日々のコーディング作業について OpenCode と Claude Code を比較します。
 #コーディングエージェント
#ollama
#エージェント権限
#コードレビュー