コーディングエージェント向けのローカルAIモデル選びを解説する、2026年10月の実践ガイドです。GPUメモリ、KVキャッシュの増加、コンテキスト長、量子化品質、プロンプト処理、推論設定、クラウドレンタル費用を比較します。
 #コーディングエージェント
#vram
#コンテキストウィンドウ
#量子化
#llama.cpp
主要な Vast.ai GPU で測定した Llama 3.1 8B と Qwen3.8 27B の Ollama ベンチマーク。デコード速度、長いコンテキスト、レンタル費用、セルフホスト、API クレジット、サブスクリプションを比較します。
#Qwen3.8 27B
#ollama
モデルサイズ、VRAM、メモリー帯域、消費電力、費用、アップグレードの選択肢を踏まえて、2026年向けのローカルAI環境を計画します。
#ローカルai
#qwen3.8
#Qwen3.8 27B
#ollama
#llama.cpp
Raspberry Pi 4と5の実測値をもとに、メモリ、速度、用途からローカル言語モデルを選びます。小型のLFM2.5から3B以上まで比較します。
 Raspberry Piハードウェア上で動くローカルAIモデルのイラスト。#ローカルai
#ollama
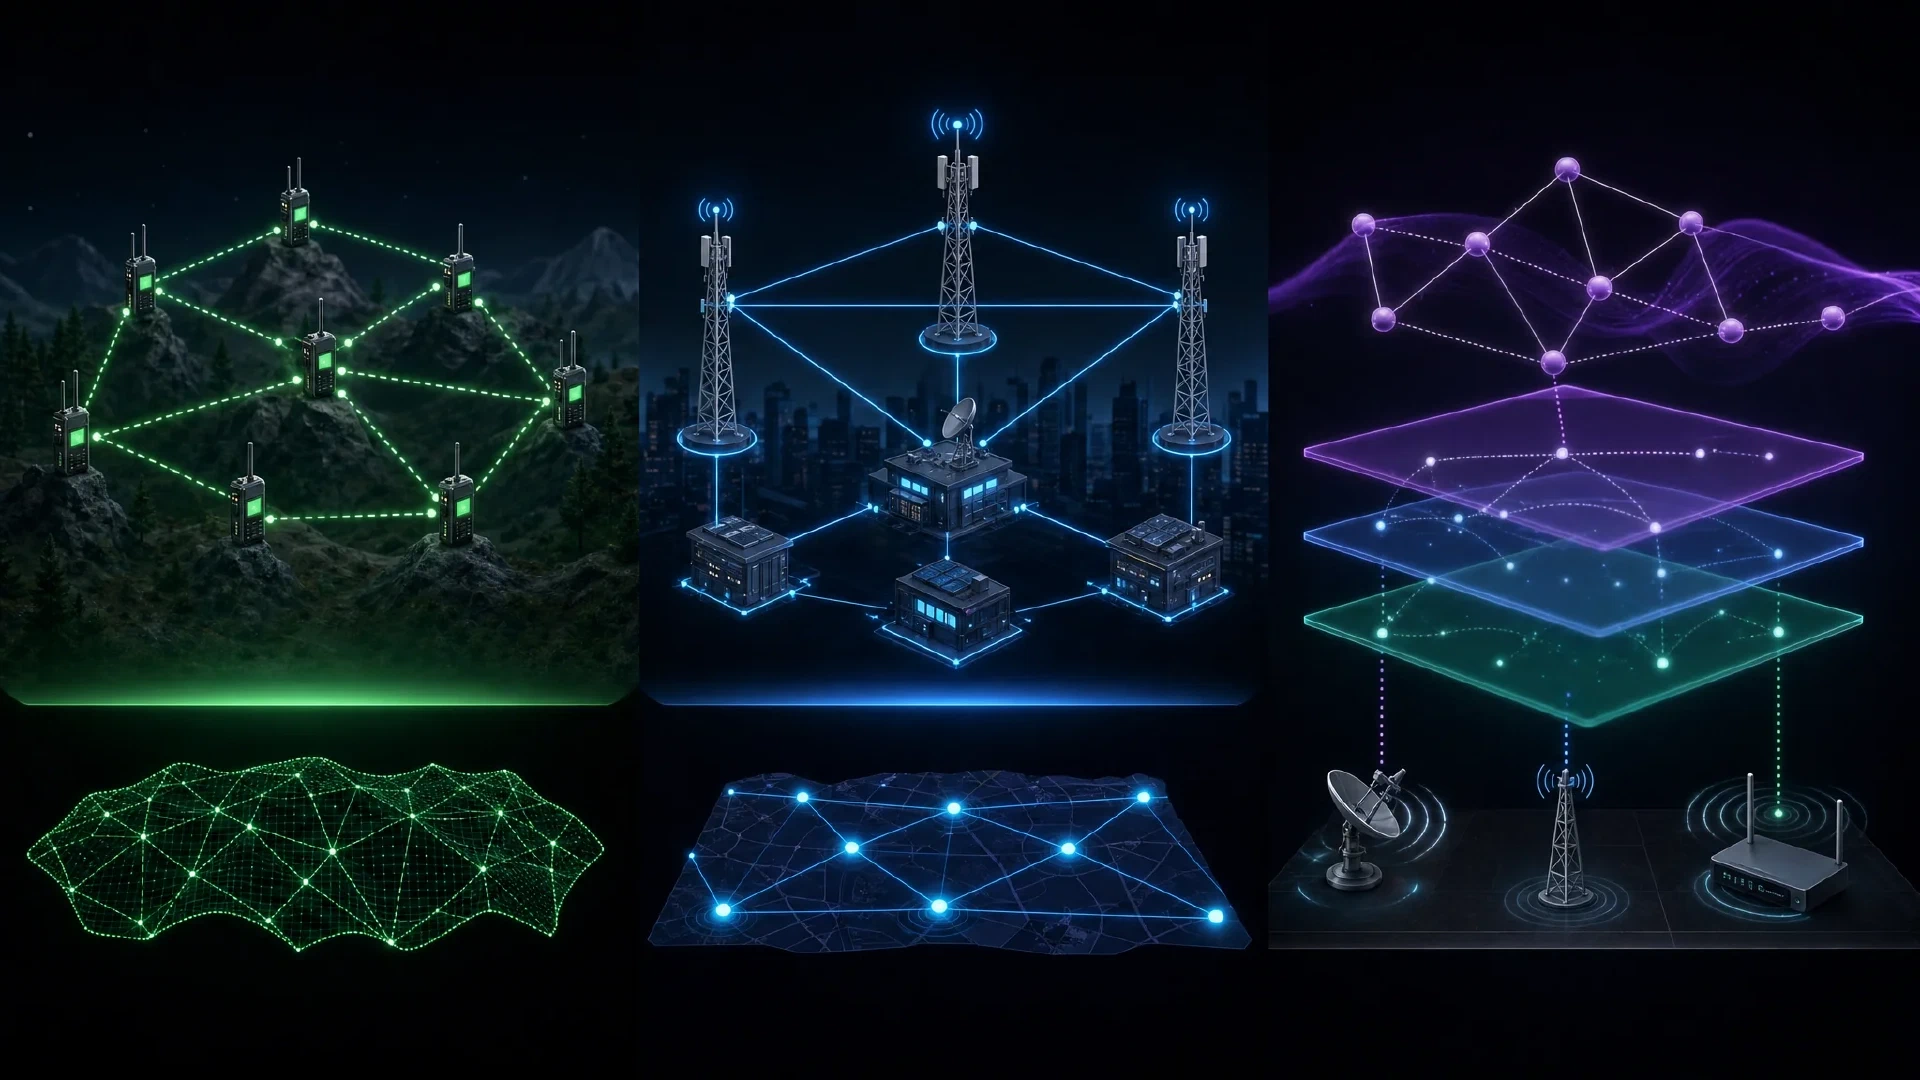
非公開の設定、キュー経由のTCPアクセス、情報取得ツール、安全性を高めたダッシュボードを備えるMeshtastic用ローカルAIアシスタントの構築記録。
 #ローカルai
#ollama
#セルフホストAI